工具不用討人喜歡,只要夠快、夠準:v-conf 2026 聽尤雨溪講 Agent 時代的工具鏈
本文是 v-conf Taiwan 2026 開場演講「V 生態最新進展及未來展望」的心得,講者是 Vue.js 與 Vite 的作者、VoidZero 創辦人尤雨溪(Evan You)。時間 2026.10.17 早上 09:30–10:15。
內容來源是我現場拍的投影片、我自己的筆記,還有大會的 HackMD 共筆。文中是我聽完後的整理與轉述,不是講者原話的逐字紀錄,我盡量只寫有把握的部分。理解有偏差的話是我的問題,不是講者的。
早上九點半,第一場就是尤雨溪。
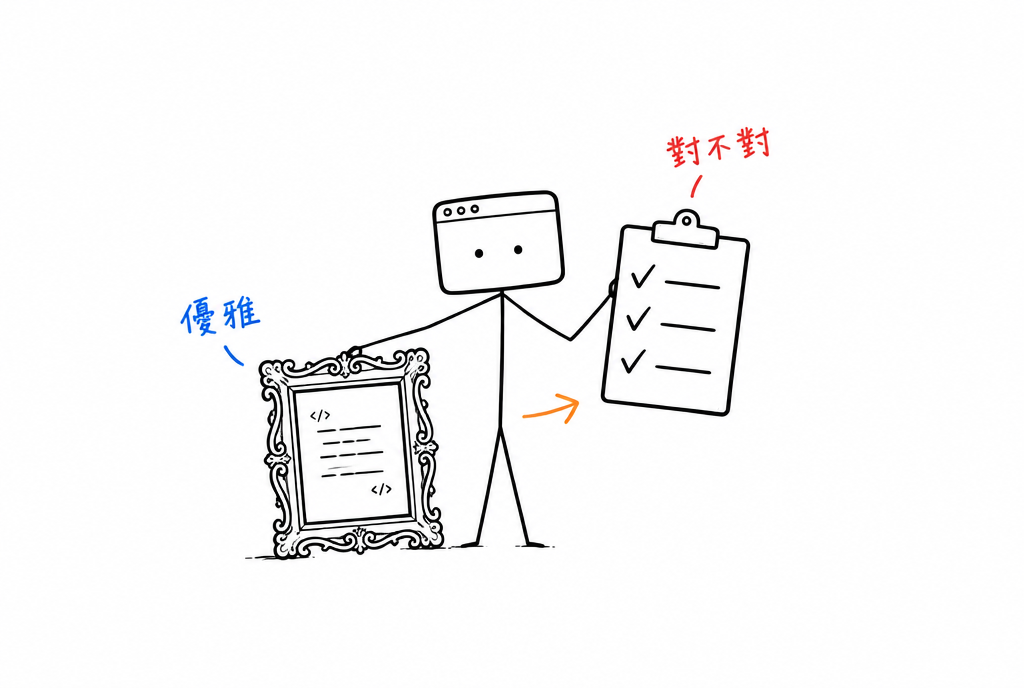
我原本以為會聽到很多 Vue 4 的消息。結果這場最讓我記住的,是後半段一句很直白的話:人寫程式會在意優不優雅,agent 不在意。
它只在意一件事:改完之後,到底有沒有壞掉。
前半段:V 生態的近況(共筆整理)
前半段我筆記記得比較零散,主要參考共筆。共筆上記下來的重點:
- alien-signals 讓 Vue 3.6 的響應式效能有很大提升。
- 規劃中的 Vue 4 可能會跟 3.6 一起升版。
- Vite 8 完整遷移到 Rolldown 和 Oxc。
- Vite 正在參考 Webpack 在大型專案上的做法,做效能優化。
- VoidZero 加入 Cloudflare,方向是繼續做開源、把 JavaScript 生態補完整。
- Void:原本想做成 Vercel 的競品,現在走開源。定位是讓公司可以很快 vibe coding 出一個 demo,概念上參考了 Laravel 的 Inertia(Void 快速開始)。
共筆上還有一條寫「Rust 重寫 TypeScript(快要有大新聞?)」。這段我筆記上沒記到,不知道確切指的是什麼,先記著,等官方消息。
寫程式的人,從一個變成幾百個
後半段才是這場的主菜。
Evan 先把 AI 寫程式的演進講了一遍。最早是在編輯器裡,AI 幫你補一行。後來是在 CLI 裡跟 agent 說「這裡改一下」。再後來是丟一份很長的規格,agent 自己跑十幾二十個小時。
現在很多人一台電腦同時跑三四個 agent。更誇張的,是在雲端開幾十、幾百個 agent 平行做事。他提到 Cursor 有工程師一個月可以 merge 上千個 PR,背後就是幾百個雲端 agent 在跑。
這段我聽得很有感。我自己現在寫部落格、剪 Podcast,也是同時開好幾個 session 在跑。人的角色已經很明顯在往「派工跟驗收」移動。
開源的護城河,正在被 token 磨平
接著他講了一段開源的現實,我覺得是全場最誠實的一段。
以前 Vue、Vite 用 MIT 授權,不太擔心別人直接拿走。因為大家信任的不是程式碼本身,是有人持續在維護它。別人 fork 一份,要重寫的成本很高,後續維護的成本更高,所以 fork 出來的東西很難取代原本的專案。
但現在 token 便宜,甚至對某些公司來說幾乎無限。他舉了 Bun 的例子:Bun 最近推出的 linter 和 formatter,在他看來基本上就是讓 agent 照著 Oxlint 的實作,整合進 Bun 裡。
他用的詞是「有點無語」。
我聽到這裡心情有點複雜。我自己有一篇在整理開源授權商用前的檢查清單,當時想的都是「授權條款允許什麼」。但 Evan 講的是另一層:就算授權完全合法,「重寫的成本很高」這道牆,已經不存在了。
那開源專案還剩什麼護城河?他沒有給標準答案。我猜他後面講的那些工具方向,某種程度就是他的回答:做到 agent 自己重寫不出來的速度跟深度。
Agent 不需要開心,它需要知道自己錯了沒
這是我覺得整場最重要的觀念轉換。
人寫程式有很多偏好。我們在意開發體驗,寫得不開心效率就會掉。所以過去十幾年,工具都在做人體工學:API 要好記、要優雅、要有彈性。他提到 DHH 覺得 Ruby 是一種很美的語言,這種審美對人來說是真的重要。
但對 agent 來說,這些都不算數。
Agent 不在乎你的 API 美不美。它在乎的是:一次能不能做對、做錯了能不能馬上知道、結果能不能被機械化地驗證。
這段是我整場印象最深的。
我寫前端十幾年,「優雅」一直是一種隱形的評分標準。code review 的時候,我們會說「這樣寫比較乾淨」「這個命名比較好讀」「這段可以再抽象一層」。很多爭論其實沒有對錯,只是誰的品味贏。
Evan 這段話等於是說:以後寫程式的主力如果是 agent,這套「人類視角的優雅」就不再是第一優先。程式碼要的是一次寫對、錯了馬上被抓到、可以被工具機械化地驗證。至於好不好看,agent 沒有這個需求。
老實說,聽到的當下我有一點失落。但想一想又覺得很合理。我們追求優雅,很大一部分原因是人要讀、人要改、人讀不懂就會出錯。如果主要讀跟改的變成 agent,那「讀起來舒服」的價值自然會往下掉,「錯了能不能馬上知道」的價值會往上衝。
品味沒有消失,只是換了位置。它不再放在一行一行的寫法上,而是放在你怎麼設計驗證、怎麼定義「什麼叫做對」。
Agent 的工作方式本質上是一個迴圈:產生一點、驗證一下、再產生下一點。模型本身是不確定的,後訓練可以讓它寫得越來越好,但它沒辦法自己保證輸出一定對。所以每一步都要靠工具驗證,確認這一步對了,才能往下走。
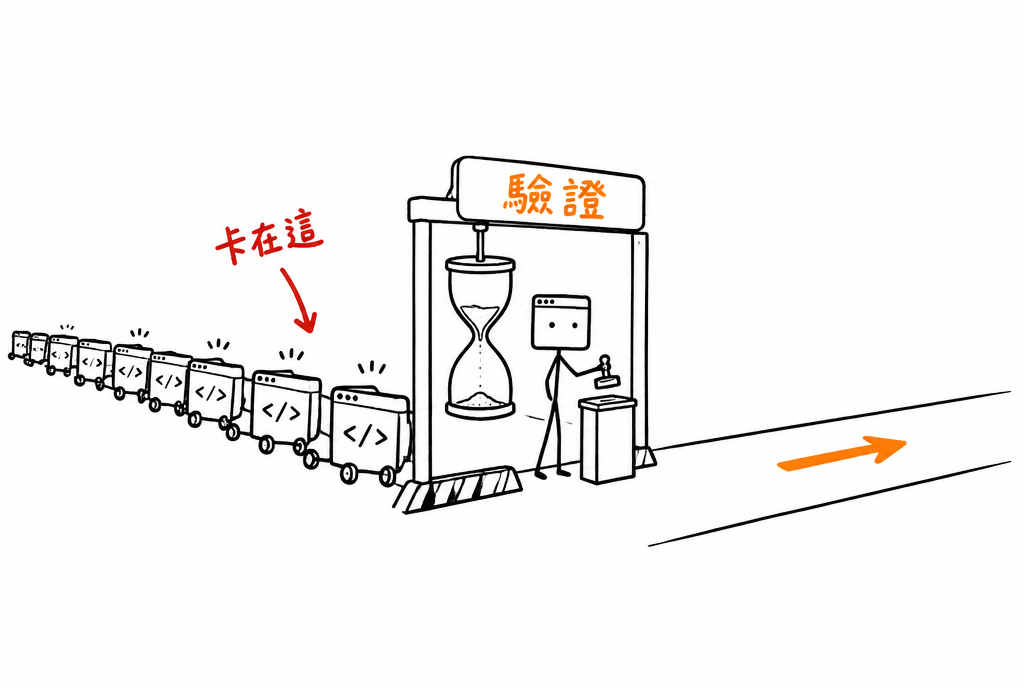
這裡他講了一句我很認同的話:驗證有多慢,就會把 agent 的效率拖多慢。
Agent 寫程式其實很快。慢在哪?一個測試要跑五分鐘,agent 就在那邊說「我在等測試跑完」,什麼事都沒做。
投影片上把這件事畫得很清楚:
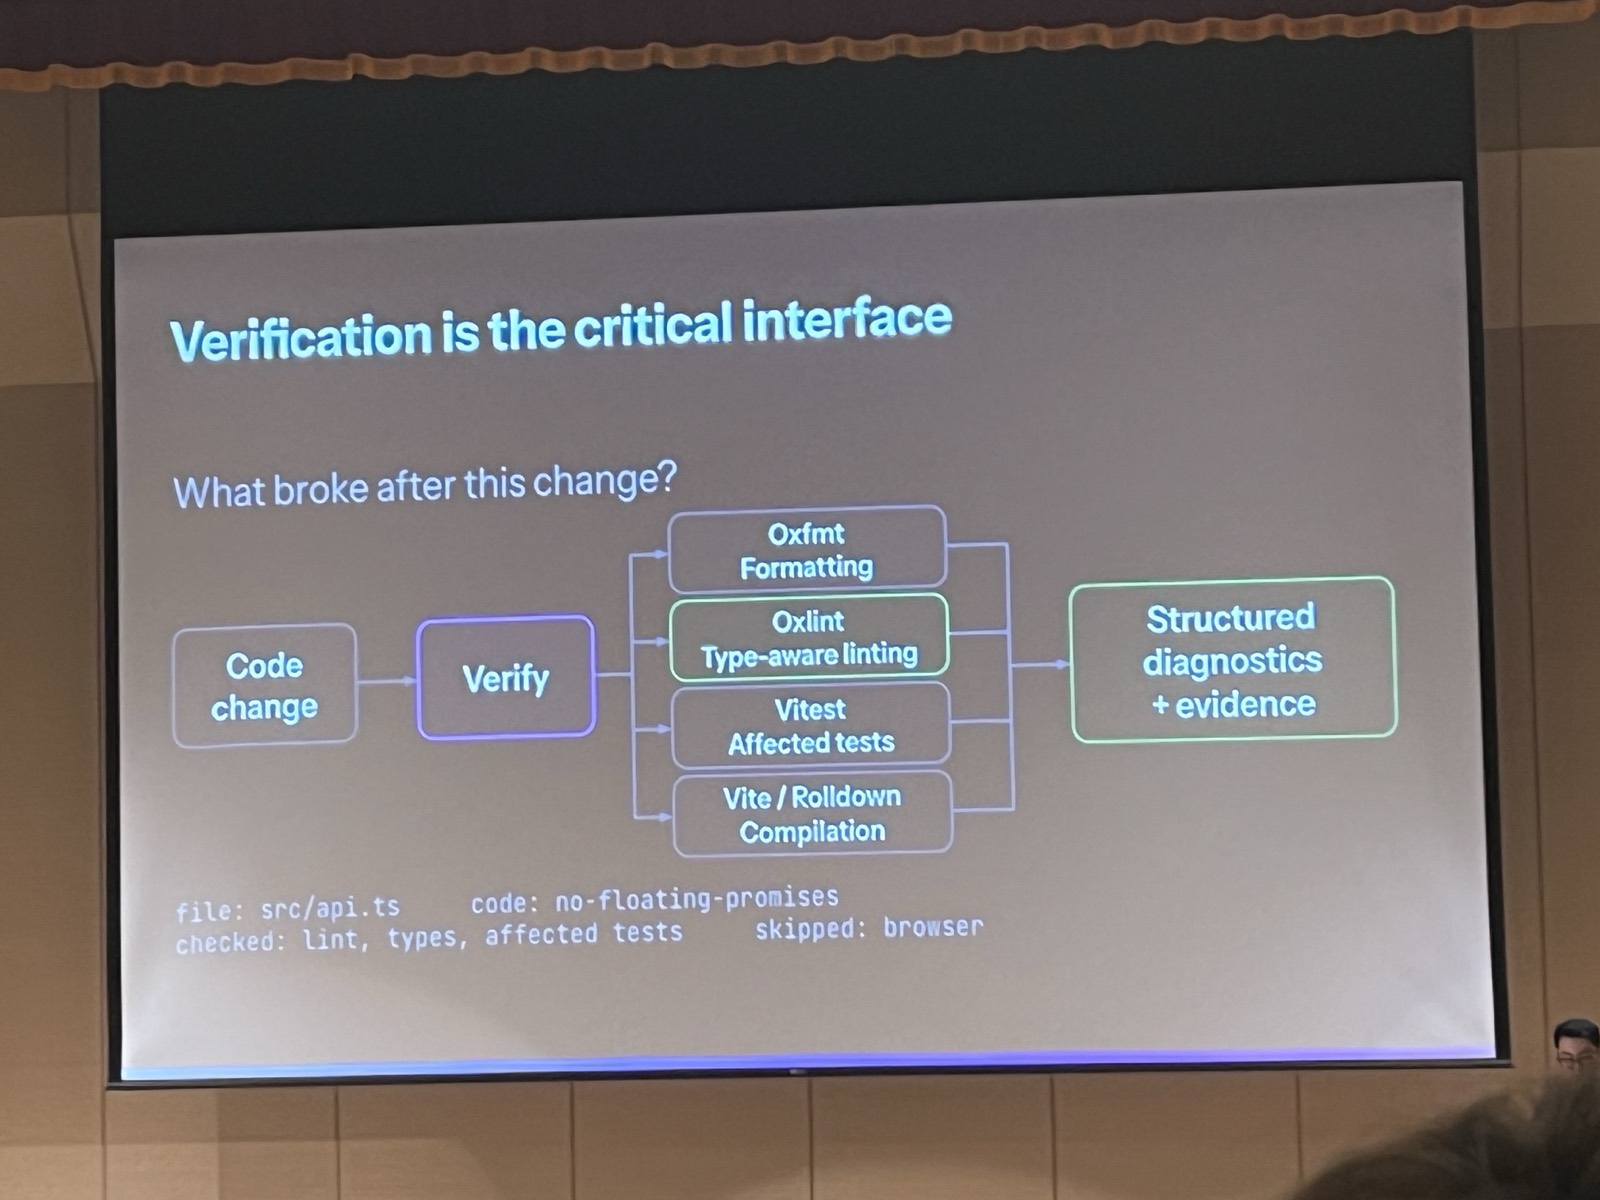
改動進來,同時跑格式化、型別感知的 lint、只跑受影響的測試、編譯,最後吐出一份結構化的診斷跟證據。注意下面那行小字:checked: lint, types, affected tests / skipped: browser。連「我沒檢查什麼」都要講清楚。
他還特別點名 flaky test。測試偶爾過、偶爾不過,agent 就得多跑好幾遍,最後跟你說「這個測試好像不穩,但我也不知道為什麼」。同一個測試花了好幾倍時間,還沒有結論。這種東西要從工具層面讓它很難發生。
我自己在用 Claude Code 時就踩過這個。部落格這個專案沒有測試,npm run build 就是唯一的驗證,因為內容 schema 寫錯 build 會直接失敗。它很陽春,但它夠快、而且每次結果一樣。現在回頭看,這反而是對 agent 很友善的設計。
選項只留事實,偏好全部刪掉
第二個觀念是設定檔。
Evan 拿 Prettier 當例子。Prettier 出現之前,大家吵了好幾年要不要加分號、要不要空格、要不要換行。Prettier 出來之後,大家發現這些根本不重要,format 下去就對了。
他認為下一代工具應該更進一步:所有「人的偏好」的選項全部直接刪掉,選項只能是事實。
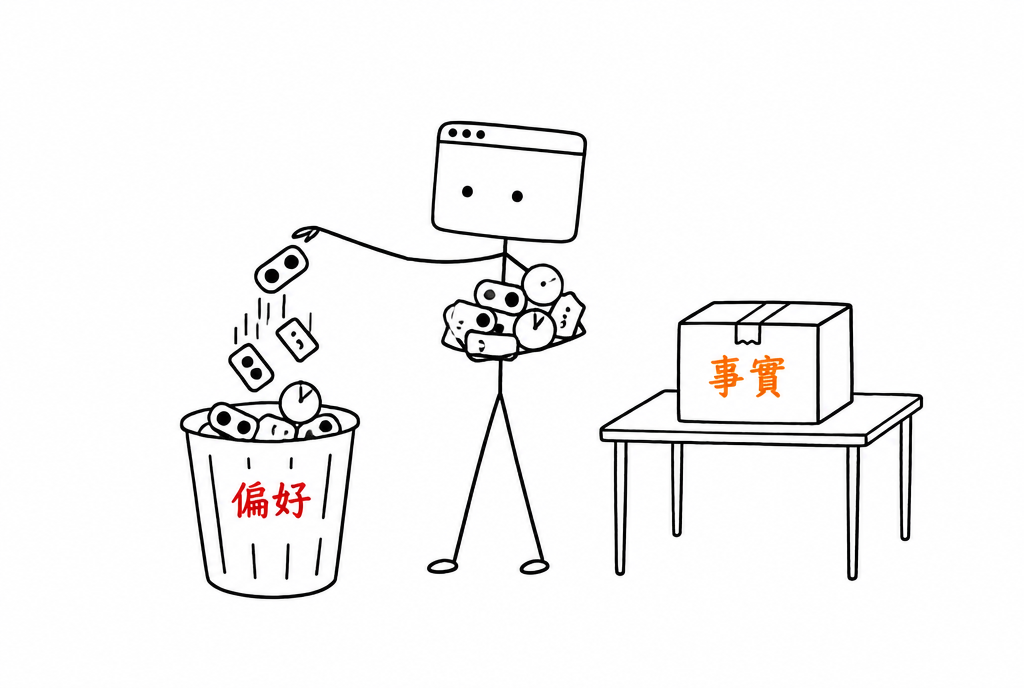
什麼是事實?檔案放在哪裡、要不要裝這個插件。什麼是偏好?要不要加分號。後者根本不該成為選項。
這對 agent 的意義很直接:選項越少,agent 要猜的就越少,每個專案的行為就越一致。
我在寫 CLAUDE.md 的時候也有類似的體會。寫「請保持程式碼整潔」這種偏好,agent 看了等於沒看。寫「驗證方式是 npm run build,schema 錯了會失敗」這種事實,它就照做。
別再讓 agent 用 grep 找東西了
第三點是 Evan 講的「Codebase understanding as a service」。
你去看 agent 的工具呼叫紀錄,會發現它大量在用 grep。用文字搜尋在倉庫裡找東西,找到一堆檔案,讀進來,再自己推測結構。
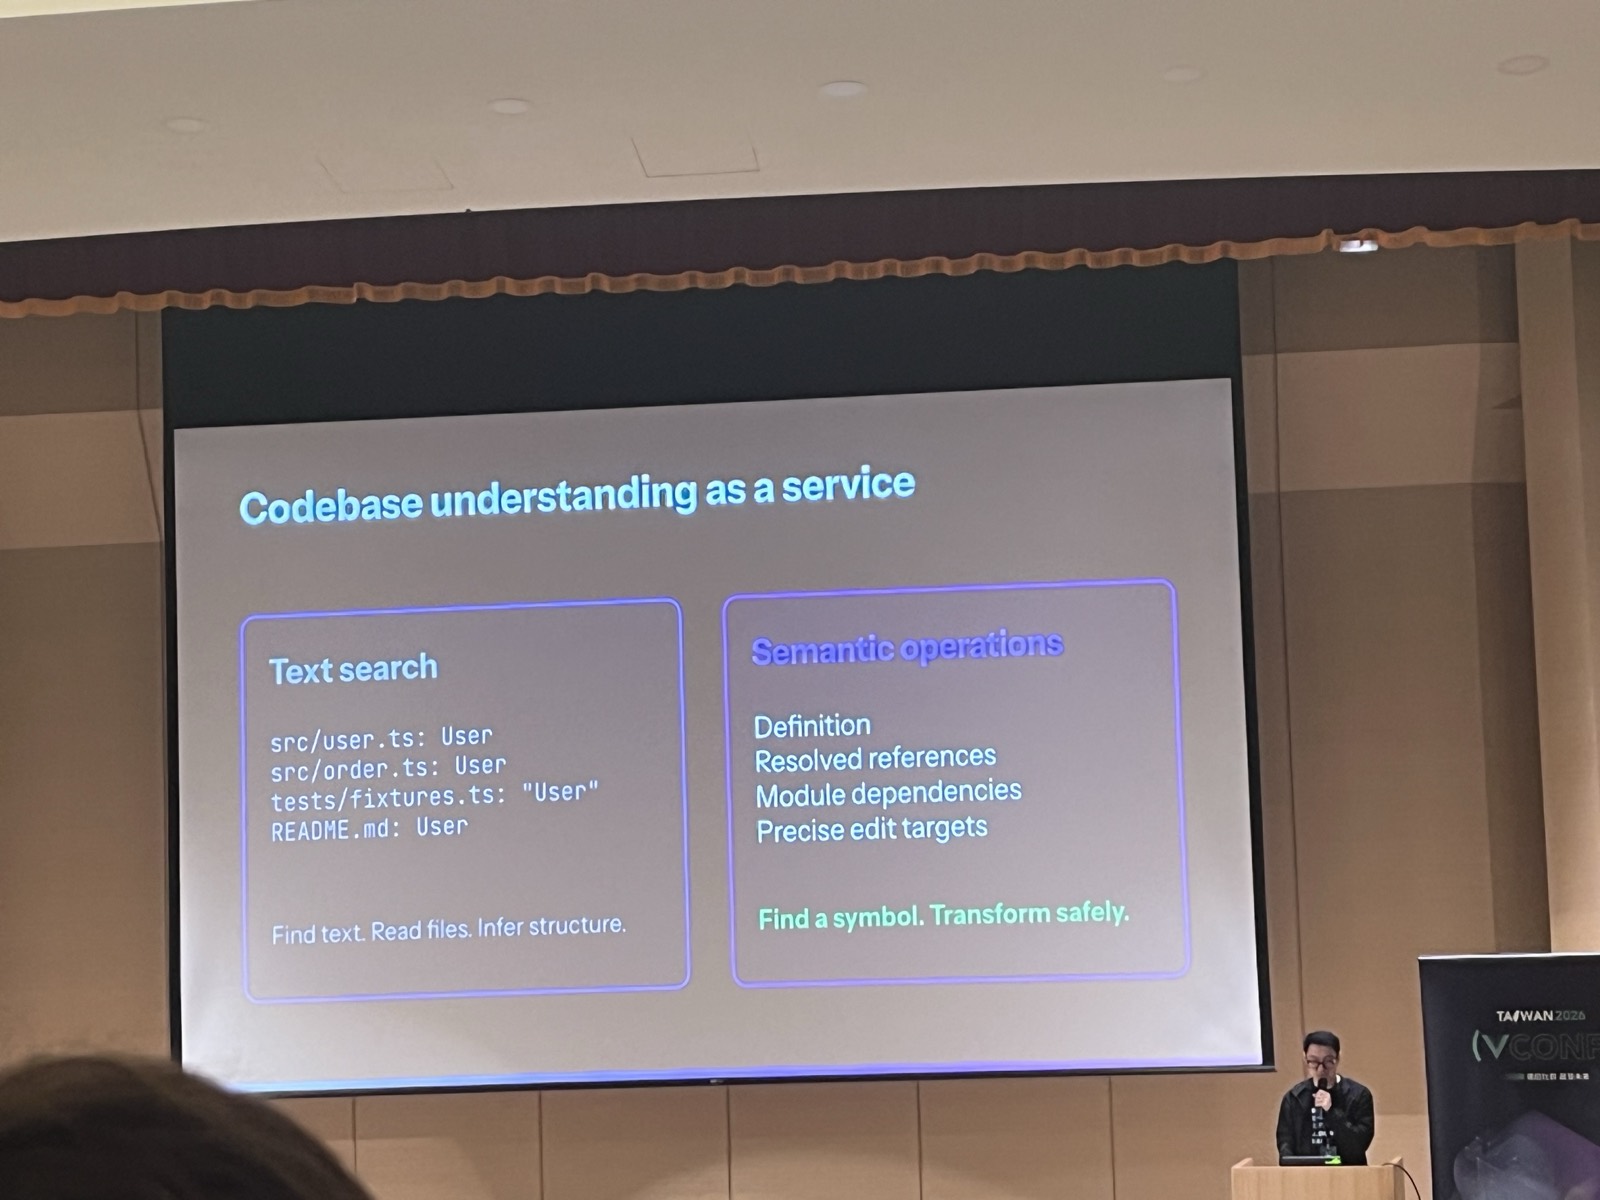
左邊搜 User,會把 README.md 跟測試 fixture 裡的字串一起撈出來。右邊是語意操作:定義在哪、誰真的引用了它、模組依賴關係、可以安全修改的精確位置。
可是工具鏈本來就有 parser、有 module graph。「這個函式在整個倉庫哪裡被用到」「這個模組被誰引用」,這些問題工具可以比 agent 自己找快一百倍回答。
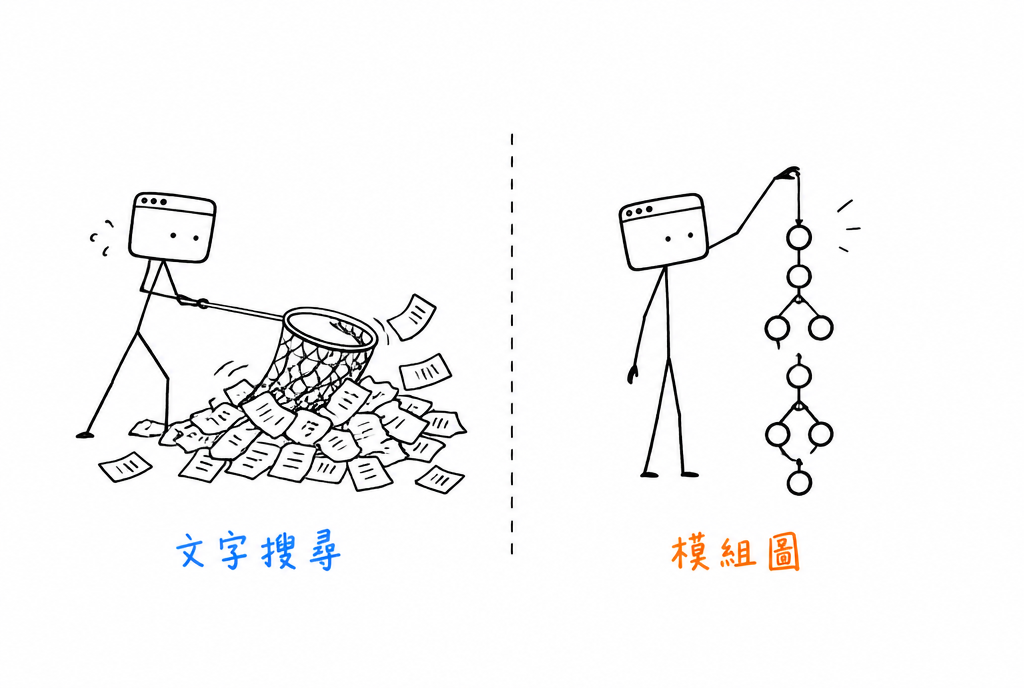
所以他認為工具應該給 agent 一級公民的 API,直接回答這些問題,而不是讓 agent 自己去猜。
同樣的邏輯也用在瀏覽器。現在很多 agent 要知道「按下按鈕後發生什麼事」,會用 Playwright 開一個真的瀏覽器、截圖、看畫面,很沒效率。工具其實可以自己驅動瀏覽器、在頁面裡注入 JavaScript,再用結構化的 API 把事件、例外、花了多少時間直接回給 agent。投影片上這叫 Runtime observability for agents。
這段我很有共鳴,因為我前陣子才寫過 Chrome CDP skill,就是想讓 Claude Code 少靠截圖、多讀結構化的資料。原來工具作者那一端,也在往同一個方向想。
build、lint、test 每次都從頭再來一遍
第四點我覺得是 VoidZero 接下來最可能做的東西。
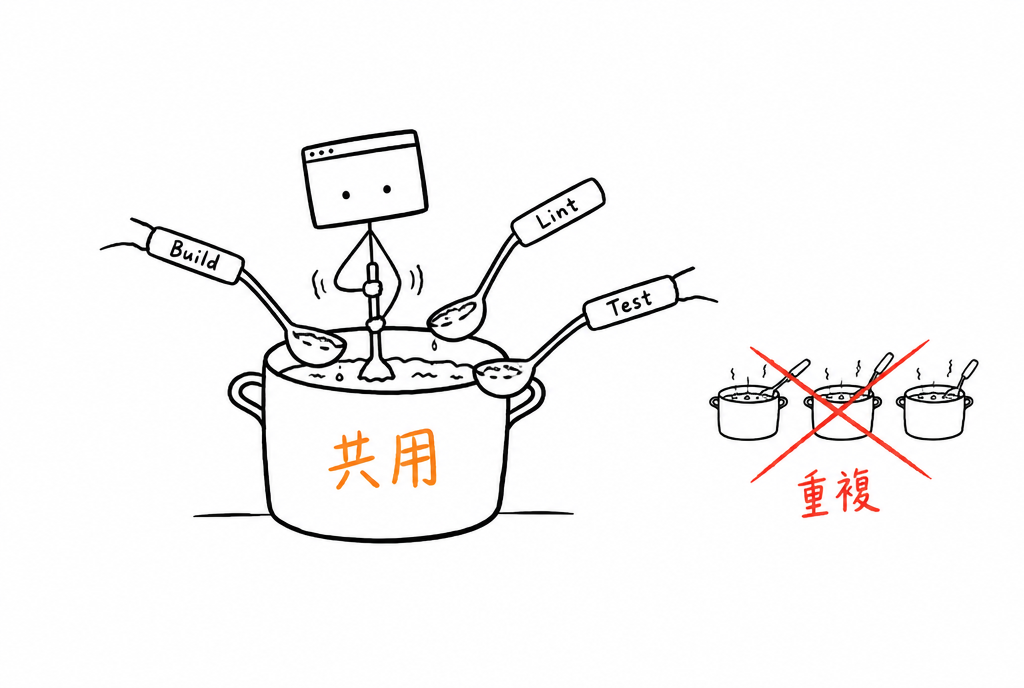
就算 Rolldown、Oxlint、Vitest 每一個都已經很快,你透過 CLI 呼叫時,每個工具還是從頭開始:同樣的檔案 parse 一遍、transform 一遍、resolve 一遍。不同任務之間完全沒有共享。
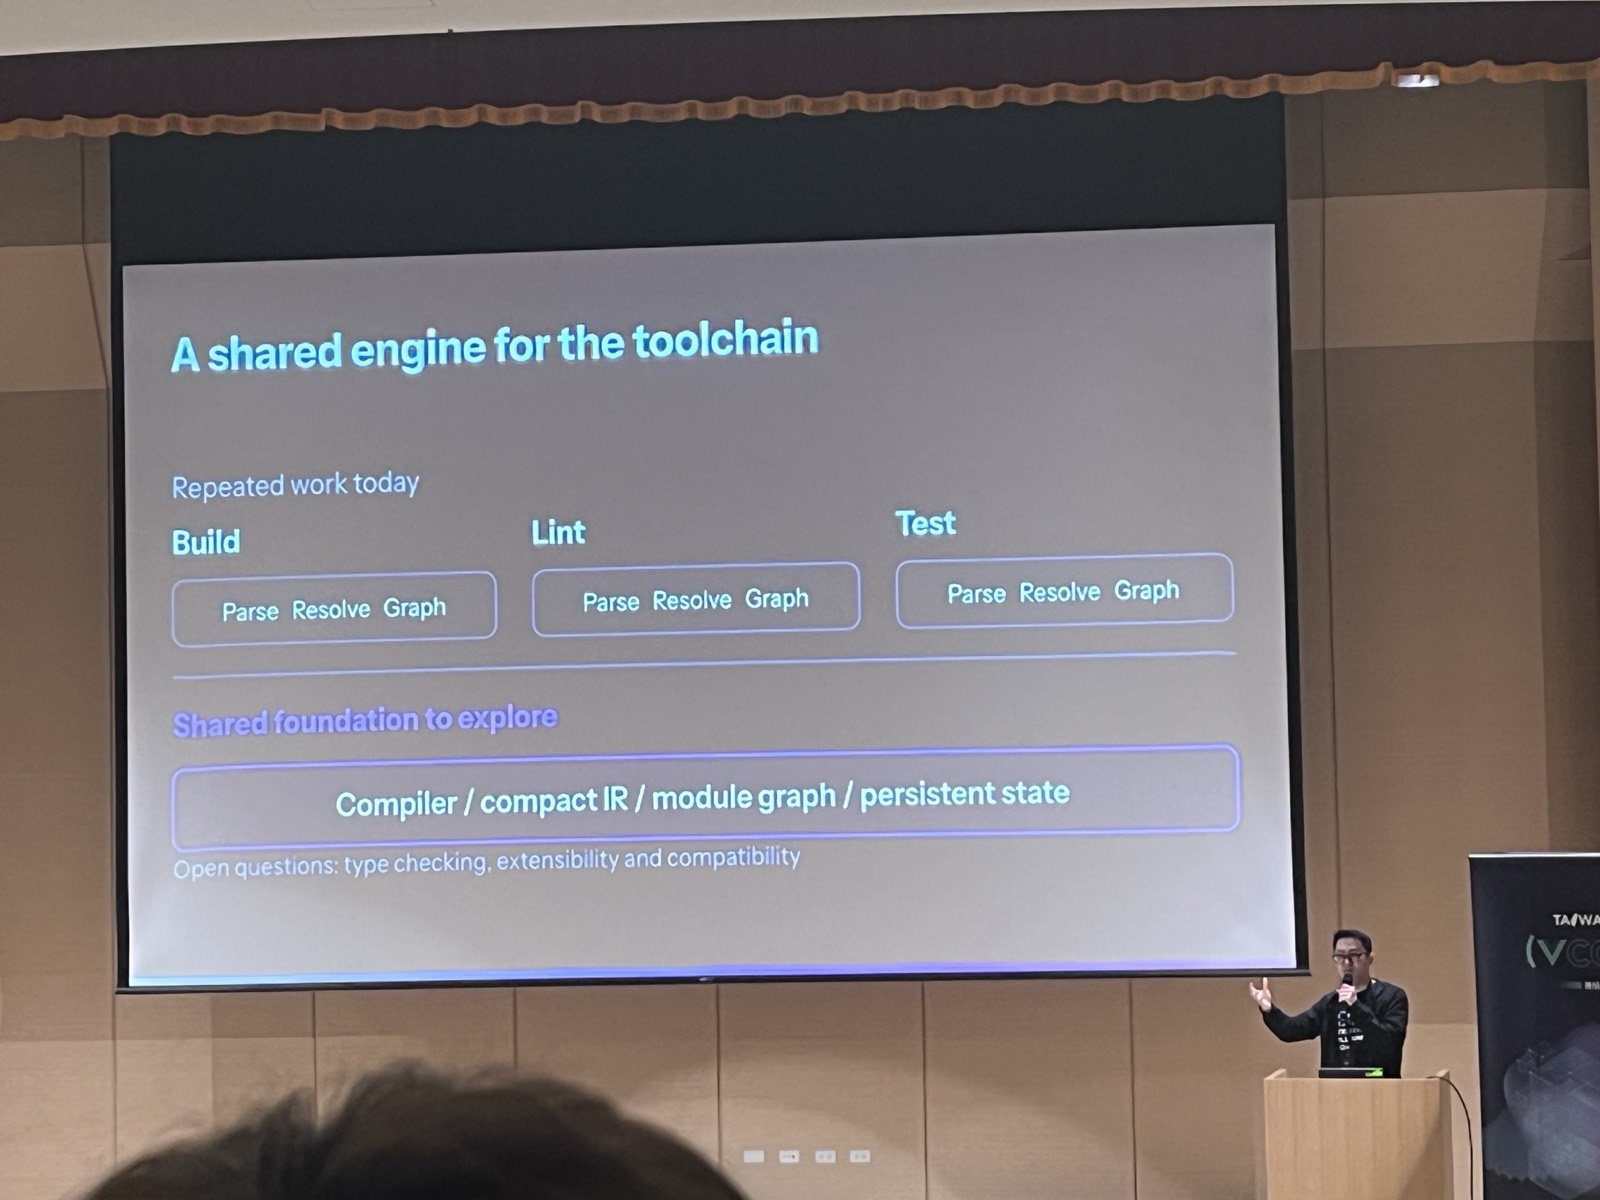
他提的方向是一個長駐的程序,把整個倉庫的 module graph 狀態放在記憶體裡。lint、bundle、format 都只是對這份 graph 做查詢。這樣不同任務可以共享工作,也能真正做到增量處理。
再往前一步是 worktree。現在同一台電腦跑多個平行 agent,大多是每個 session 複製一份 worktree,各自改。問題是很浪費:他說開三個 dev server,記憶體就不夠了。
他的想法是用不可變資料結構的 structural sharing。多個 worktree 之間沒改到的檔案,在記憶體裡共用同一份;每個 worktree 只為自己改動的部分付出額外的記憶體。
投影片下方有一行小字:type checking、擴充性、相容性,都還是 open questions。這不是已經做好的東西,是還在探索的方向。
他已經在做了,但還不能講
最後他提到 Cloudflare 的新 CLI cf(目前 beta)當作 agent-first 設計的例子:用 cf cli search 讓 agent 自己發現有什麼功能,用 cf schema 看參數,結果一律回 JSON。開發到部署則是 cf dev、cf build、cf deploy,底下是 Vite。
收尾時他說,剛剛講的這些點,需要拋開一些既有的設計思路重新打造。他這陣子就在做這樣一個東西,現在還沒辦法分享。如果順利,可能今年晚些時候、或明年初,會再跟大家介紹。
敬請期待。
我帶回家的三件事
聽完這場,我回頭看自己平常怎麼跟 agent 協作,有三件事想馬上改:
- 先讓驗證變快,再求 agent 變聰明。 agent 卡住的時候,我以前的第一反應是換模型、改 prompt。現在我會先看:它是不是在等一個很慢、或結果不穩定的驗證?
CLAUDE.md只寫事實。 指令放哪、怎麼驗證、哪些檔案不能動。「請寫得優雅一點」這種話,刪掉。- 能給結構化資料,就不要給截圖。 不管是 build 錯誤、瀏覽器狀態,還是倉庫結構,agent 讀 JSON 比看圖可靠得多。
前端工具這十年一直在讓「人」寫得更舒服。這場演講讓我意識到,下一個十年的工具,客戶可能主要是 agent。它不需要被取悅,它只需要很快地知道:我剛剛改的那一行,到底弄壞了什麼。
謝謝 Evan 一大早就把這麼多思考毫無保留地分享出來,也謝謝 v-conf Taiwan 的工作人員把共筆整理得這麼完整。