人在外面逛街,Podcast 在家裡剪:我怎麼讓雲端 AI、自己的 Mac 跟手機一起剪完一集訪談
今天傍晚我在外面逛街,一集 65 分鐘的訪談 Podcast 從 v5 改到 v9。v9 是我第一個聽完說「可以了」的版本。
這段時間我沒碰電腦。我做的事情只有三件:用藍牙耳機聽、在手機上打字回饋、選 A 或 B。
剪輯本身是 Claude 做的。但讓這件事成立的關鍵不是「AI 會剪片」,而是分工:判斷在雲端,苦工在我家的 Mac,耳朵在我的手機。
三個位置,三種工作
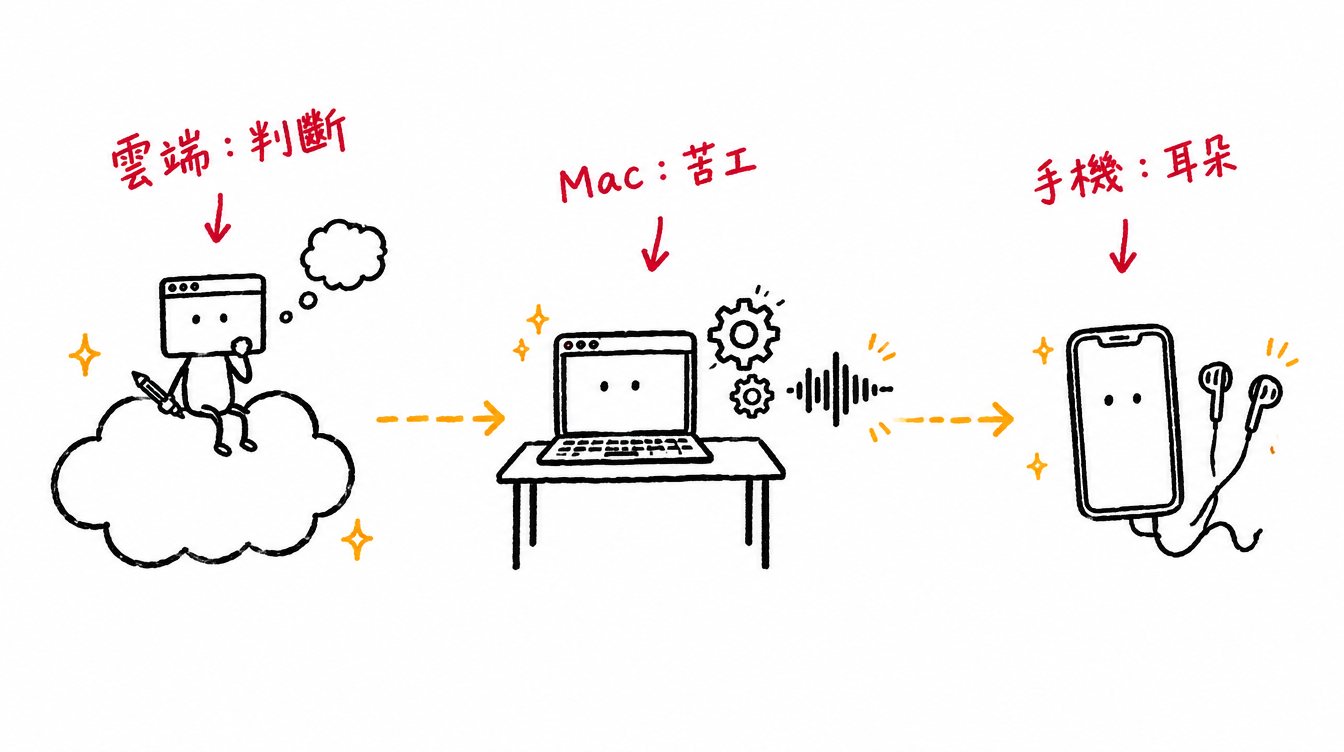
雲端:我跟 Claude 的對話跑在 Anthropic 的雲端工作階段。它負責判斷要剪哪裡、寫剪輯程式、下指令。字幕要校對時,它會開兩個分身,各讀一半同時抓錯字。
我的 Mac:Claude 桌面版連上這台 Mac 之後,雲端那邊可以在 Mac 裡開一台小型 Linux 虛擬機,只看得到我授權的幾個資料夾。ffmpeg 剪接混音、faster-whisper 離線辨識逐字稿,都在這台虛擬機裡跑。
我的手機:同一個對話在手機的 Claude App 也看得到。成品寫進 iCloud 資料夾,我在路上用手機開來聽。
為什麼不乾脆整包丟上雲端剪?因為原始錄音是 RODECaster 的多軌 WAV,三個檔加起來將近 10 GB。上傳要很久,而且這是還沒公開的錄音,留在自己的電腦上比較安心。
所以錄音檔從頭到尾沒離開過我的 Mac,離開的只有指令跟文字。
有在玩 AI 代理的人看到這裡,大概會覺得很像「小龍蝦」(OpenClaw):在自己的電腦上養一個 AI 代理,人在外面用手機傳訊息叫它做事。
概念確實很像,差別在我沒有自己架任何東西。我用的是 Claude 桌面版:把對話連結到這台 Mac,雲端的 Claude 就能在 Mac 上開虛擬機、讀寫我授權的資料夾;出門後在手機的 Claude App 打開同一個對話,接著講就好。不用開伺服器、不用接通訊軟體的機器人,也不用自己管 API 金鑰。
代價是它只碰得到我授權的那幾個資料夾,而且 Mac 要開著、桌面版要在線上。對剪 Podcast 來說,這個範圍剛剛好。
剪輯是一條分段的生產線
流程長這樣:
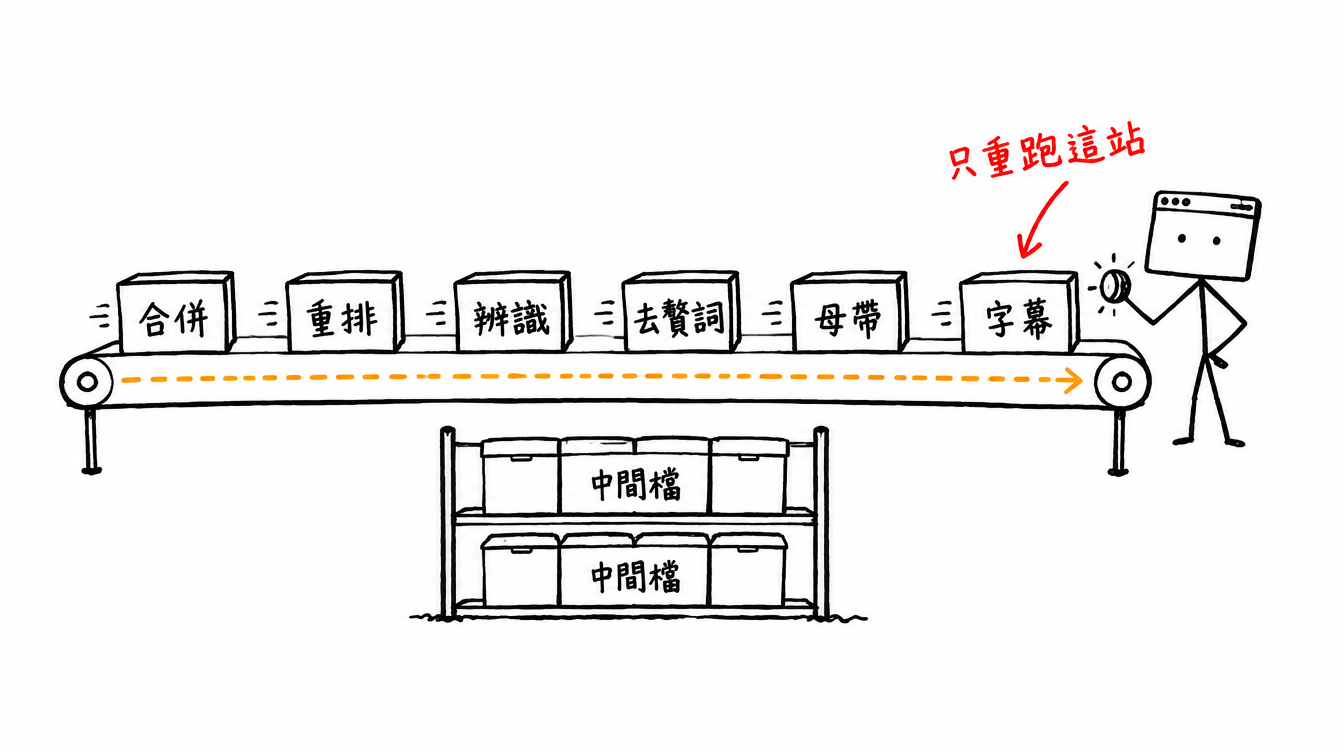
WAV 合併 → 照剪輯企劃重排段落 → 逐字語音辨識 → 刪贅詞 → 母帶(加速、縮停頓、鋪背景音樂、插廣告、接片頭片尾、片尾彩蛋)→ 字幕。
這條線會長成這樣,是被限制逼出來的。
那台虛擬機每個指令最多跑 3 分鐘,背景程序在指令結束後也會被收掉。90 分鐘的錄音光是辨識一輪,就要切成幾十段慢慢跑。
所以每一站都寫成「做過就跳過、沒做完就接著做」。中間檔先寫成 .tmp,完成才改名。逾時了就再下一次同樣的指令,它會從斷掉的地方繼續。
這個設計在後面回饋時變成優勢。
我說「背景音樂太小聲」,只要重跑鋪 BGM 之後的幾站。我說「整體音量再大一點」,只要拿已經組好的整集重新調增益、轉 MP3,大概一分鐘。我說「彩蛋換一下」,只重做那 35 秒,再重新組裝。
前面最花時間的合併、辨識、去贅詞,都不用重來。
九個版本,每一版只改一件事
回頭整理,這集一共出了九版。每一版都是我聽完丟一句回饋,它只改那一件事:
| 版本 | 改了什麼 | 為什麼 |
|---|---|---|
| v1 | 結構剪+去贅詞+母帶,約 64 分鐘 | 錄音照訪綱走,前 20 分鐘太悶,把我的直男按摩師故事、AA 制往前排 |
| v2 | 去贅詞的刀口改成交叉淡接 | 我聽到剪輯點有「切換聲」 |
| v3 | 重新合併麥克風分軌 | 背景嘶聲會隨換人講話忽有忽無 |
| v4 | 背景音樂調小 | 以為是 BGM 的鼓點在句間冒出來 |
| v5 | 句間停頓改成淡接 | 還是聽得到 |
| v6 | 改用錄音介面的硬體混音軌,照上一集的做法 | 真正的根因,雜音消失 |
| v7 | 背景音樂調回原本音量 | v6 的 BGM 幾乎聽不到 |
| v8 | 整體音量加大約 3 dB | 藍牙耳機要開到 90% 才聽得清楚 |
| v9 | 片尾彩蛋從一句加長成三段 | 原本的彩蛋不夠精彩 |
v2 到 v5 其實都在追同一個問題,下一節講。
最難的一個 bug:每一句之間都有「喀」一聲
這集卡最久的不是剪接,是聲音。
v3 到 v5,我每一版都聽到句子跟句子之間有切換的雜音。Claude 換了好幾種做法:接點改交叉淡入淡出、把背景音樂調小、停頓改用淡接。都沒用。
後來我跟它說:「之前的集數都沒有這個問題,你參考上一集的剪法。」
它去比對上一集的母帶程式,才找到真正的原因。
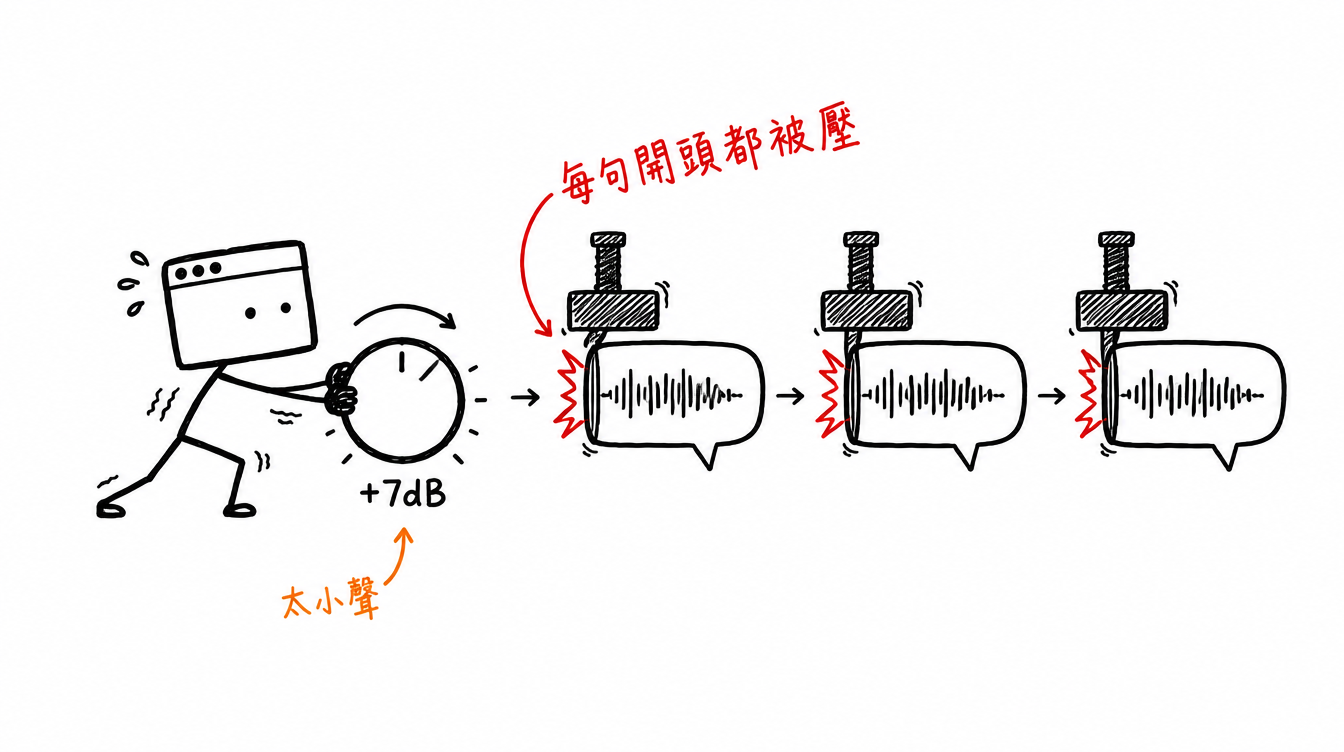
這集它一開始是自己把主持人跟來賓的麥克風分軌重新混在一起,混出來只有 -17 到 -23 LUFS,太小聲。母帶階段為了拉到目標響度,加了約 7 dB 的增益,聲音直接頂進限幅器。
結果就是每一句開頭的那個瞬間,限幅器都在壓。耳朵聽起來就是句子之間一直「喀」。
上一集的做法是直接用 RODECaster 硬體自己混好的那一軌,本來就有 -12 LUFS,人聲也不再加壓縮,限幅器幾乎不用工作。換成這個做法之後,v6 雜音就消失了。
後面 v7 到 v9 就都是「好不好聽」的微調,不再是修 bug。
我自己的收穫是:AI 換招換很快,但如果沒有一個「已知是好的」版本可以比對,它很容易一直在症狀上打轉。這時候人能提供的最大價值,是指出「上次是好的」。
我在手機上實際做了什麼
回頭看對話紀錄,我傳的訊息大概是這種長度:
「v6 已經沒有雜音,但背景音樂幾乎聽不到,幫我調大聲一點。」
「我用藍牙耳機聽,要開到 90% 才清楚,音量幫我調整一下。」
「彩蛋好像不夠精彩,有沒有其他建議?」
最後這句,它沒有直接問我要哪一段,而是先從開錄前的對稿和正片裡挑了三個候選,各自剪成十幾秒的試聽檔放進 iCloud,附上推薦理由。我在路邊聽完,回「B」,後來又改口「原本那個再加上 B、C」。幾分鐘後新版本就在 iCloud 裡了。
這是我覺得這套流程最舒服的地方:需要判斷的時候,它把判斷變成可以用耳朵做的選擇題。 我不用描述我要什麼聲音,我只要說哪個比較好。
中間踩過的坑
Mac 硬碟爆了兩次。 多軌 WAV 加上一堆中間檔,空間一下就沒了,檔案寫到一半被截斷。後來改成先在虛擬機自己的磁碟上渲染,完成後才複製回資料夾,再用 cmp 逐位元比對一次。
雲端寫回 Mac 會延遲。 有時候檔案「寫入成功」,但 Mac 上看到的還是舊版。現在每次寫回都會比對 md5,對不上就改在虛擬機裡直接產生。
隱私要逐條檢查。 訪談裡有幾處說溜的個資,包括我的本名。這些都在剪輯企劃裡列成待辦:本名用嗶聲蓋掉,可辨識的地點直接剪掉,字幕跟節目說明欄也一併檢查不能出現。AI 會照清單做,但清單要人先開出來。
結論
這一集裡,我比較像製作人,不像剪輯師。
AI 負責所有能寫成程式的事:切、接、混、辨識、校字幕、算時間軸。我負責它沒辦法替我決定的事:哪一段好笑、哪個音量舒服、什麼東西不能播出去。
而讓這件事可以在逛街時完成的,是把工作放在對的位置:判斷放雲端,重活放在檔案所在的那台電腦,最後一關留給自己的耳朵。