Zeabur ENV 外洩後:不要把部署平台當成 Secret Manager
2026 年 8 月底,Zeabur 公開了一起安全事件。根據官方 status 頁,截至 2026-08-29 21:17 UTC 的更新,攻擊者取得了一組 Zeabur 內部 AWS 管理憑證,進一步進入控制平面網路並連到主要資料庫;Zeabur 表示已確認有針對使用者專案環境變數(Variables)的查詢與匯出行為,攻擊者看起來特別鎖定 AI API keys 與其他可以直接使用的憑證。
官方列出的暴露變數名稱包含 OPENAI_API_KEY、ANTHROPIC_API_KEY、OPENROUTER_API_KEY、DATABASE_URL、JWT_SECRET、STRIPE_SECRET_KEY、GITHUB_TOKEN、AWS_ACCESS_KEY_ID、AWS_SECRET_ACCESS_KEY 等。也就是說,這不是「某一把 API key 外洩」那麼單純,而是部署平台裡的環境變數資料被讀到。
先講清楚:這篇不是要補刀 Zeabur。我用過很多部署平台,大家的開發體驗都很接近:填 env、部署、重啟、服務起來。這種模式讓小團隊跑很快,但也讓一件事被包裝得太簡單:
不要把部署平台的 Environment Variables 當成你的密碼保險箱。
ENV 不是錯,錯的是把所有秘密都丟進同一層
Environment Variables 本身不是邪惡的。它是把設定從程式碼裡抽出來的好方法,也是很多平台最通用的設定介面。
問題在於,我們常常把完全不同風險等級的東西都塞進 ENV:
NODE_ENV=productionAPP_URL=https://example.comOPENAI_API_KEY=sk-...DATABASE_URL=postgres://...STRIPE_SECRET_KEY=sk_live_...JWT_SECRET=...
前兩個是設定,後面幾個是可以直接換錢、讀資料、偽造身分、呼叫第三方資源的憑證。它們不應該被同一套存取權限、同一個後台畫面、同一條 API、同一個內部服務帳號完整讀出來。
真正要問的問題不是「平台會不會被駭」。沒有任何平台可以保證永遠不出事。
真正要問的是:
這一層被攻破後,攻擊者還能拿走多少東西?
如果答案是「所有服務、所有環境、所有第三方 API key、所有資料庫連線字串」,那架構就太脆了。
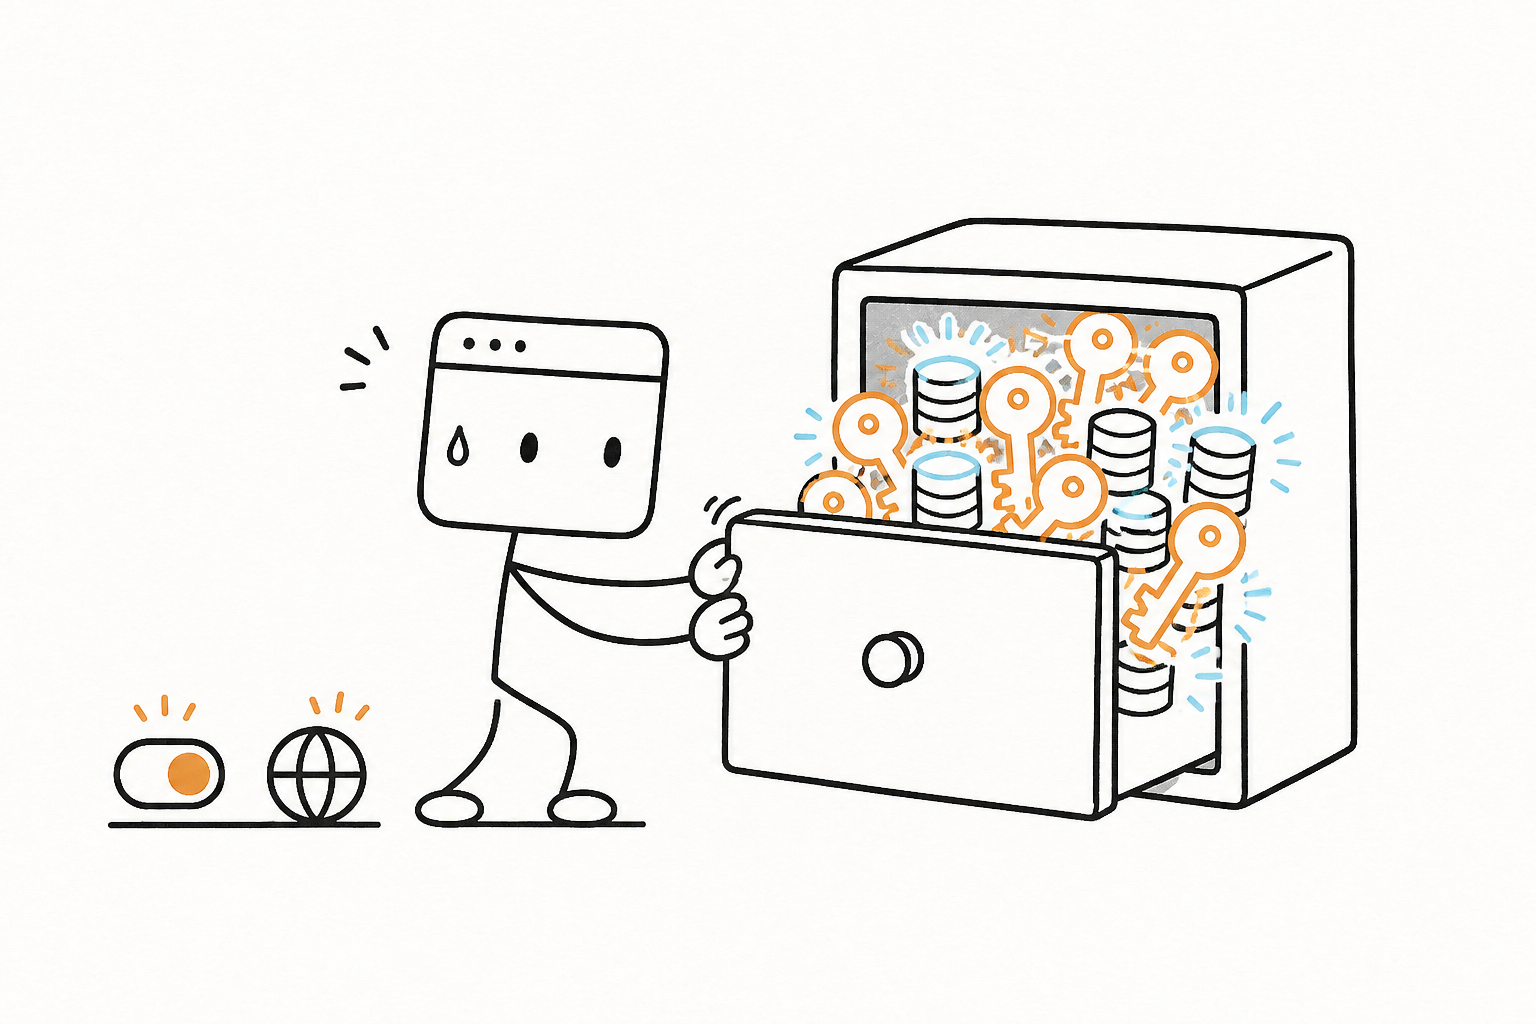
Secret Manager 不是把鑰匙換一個抽屜放
很多人的第一反應會是:那就全部搬去 Secret Manager。
方向對,但只做一半會出事。
常見的錯誤長這樣:
部署平台 ENV:
MASTER_SECRET=xxxxx

應用程式:
用 MASTER_SECRET 去 Secret Manager 讀全部 secrets
這沒有解決問題。你只是從「十把鑰匙可能被偷」,變成「只要偷到一把 master key,十扇門全部打開」。
Secret Manager 真正有價值的地方,不只是「集中保存秘密」,而是它可以跟 IAM、Workload Identity、短期憑證、存取紀錄、輪替機制接在一起。也就是:
- 哪個服務可以讀哪一個 secret
- 哪個環境可以讀哪一組 secret
- 哪個 identity 在什麼時間讀了 secret
- secret 多久輪替一次
- 被讀取、快過期、異常使用時能不能告警
如果你只是把所有密碼搬到 Secret Manager,然後再用一把長期 master credential 從部署平台讀回來,本質上還是在賭那把 credential 永遠不會外洩。
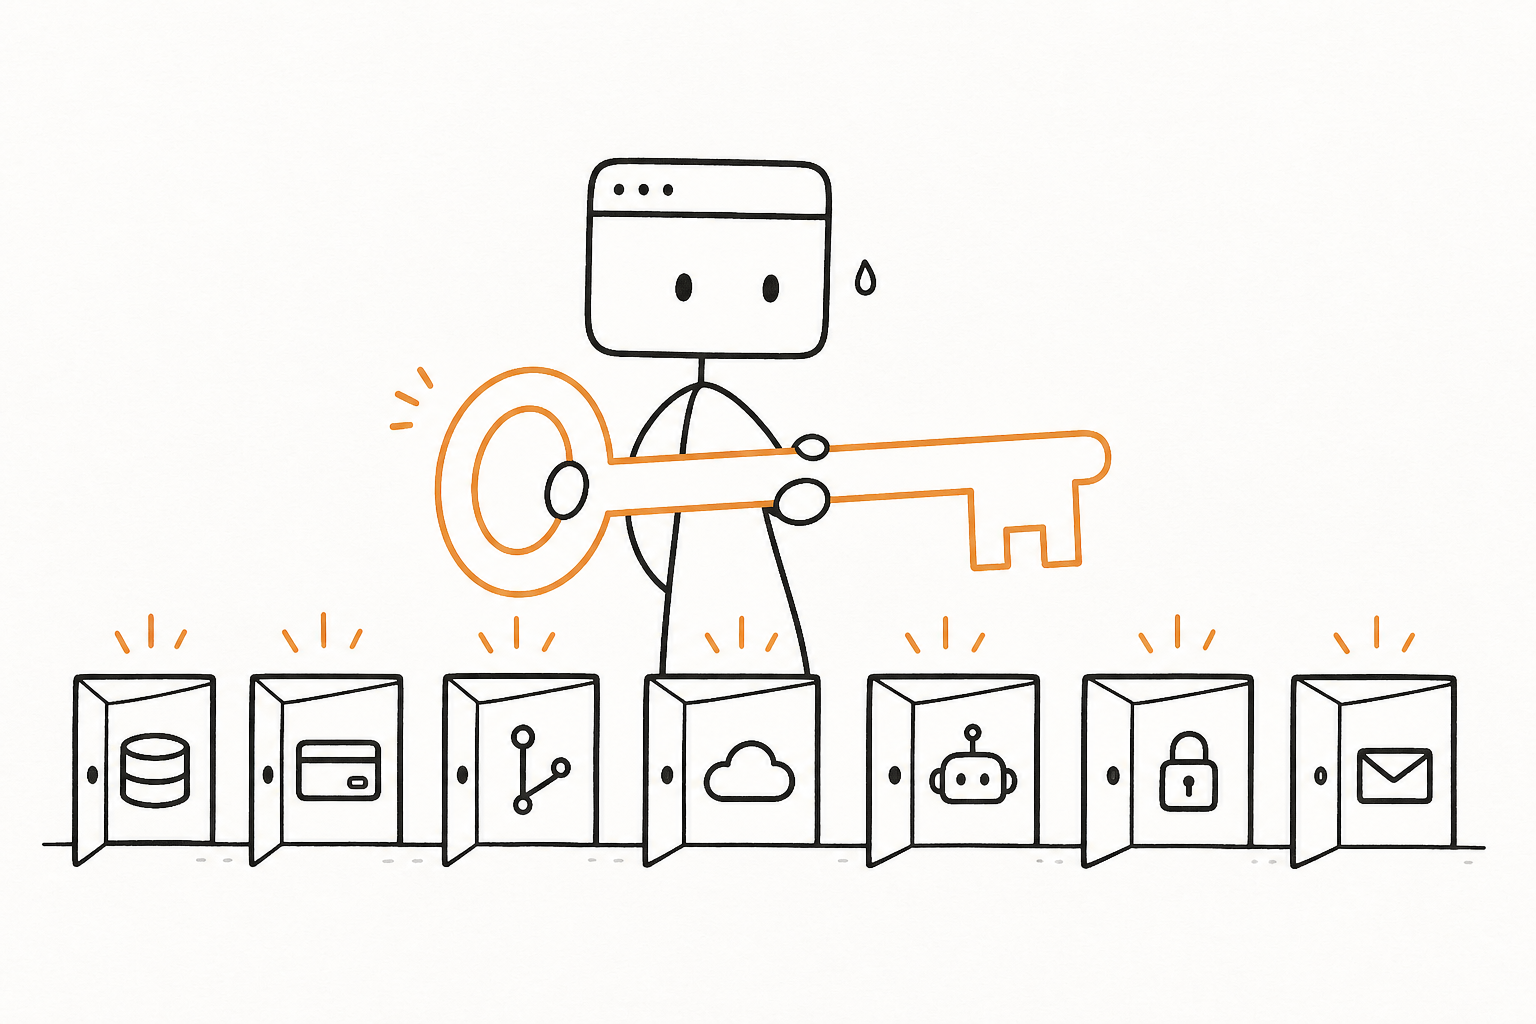
理想架構:服務用身分,不用長期密碼
現代雲端比較理想的做法,是讓 workload 本身有身分。
概念像這樣:
Service A
  -> Workload Identity / IAM Role / Managed Identity
  -> 只能讀 openai-production-key

Service B
  -> Workload Identity / IAM Role / Managed Identity
  -> 只能讀 postgres-app-password

Service C
  -> Workload Identity / IAM Role / Managed Identity
  -> 只能讀 stripe-webhook-secret
這裡沒有一把「可以讀全部 secrets」的 master key。每個服務只有它真的需要的權限,而且最好是短期憑證,不是永久有效的 client secret。
AWS 有 Secrets Manager 搭配 IAM;Google Cloud 有 Secret Manager 搭配 Workload Identity Federation;Azure 有 Key Vault 搭配 Managed Identity。名字不同,精神一樣:
讓服務拿自己的身分去換有限、短期、可稽核的權限。
這樣做的好處是,就算 Service A 的執行環境被拿到,攻擊者也只能讀 Service A 被允許讀的那幾個 secrets。它拿不到 Service B 的資料庫密碼,也拿不到 Stripe 的 key,更不能列出整個組織所有秘密。
這才是最小權限。
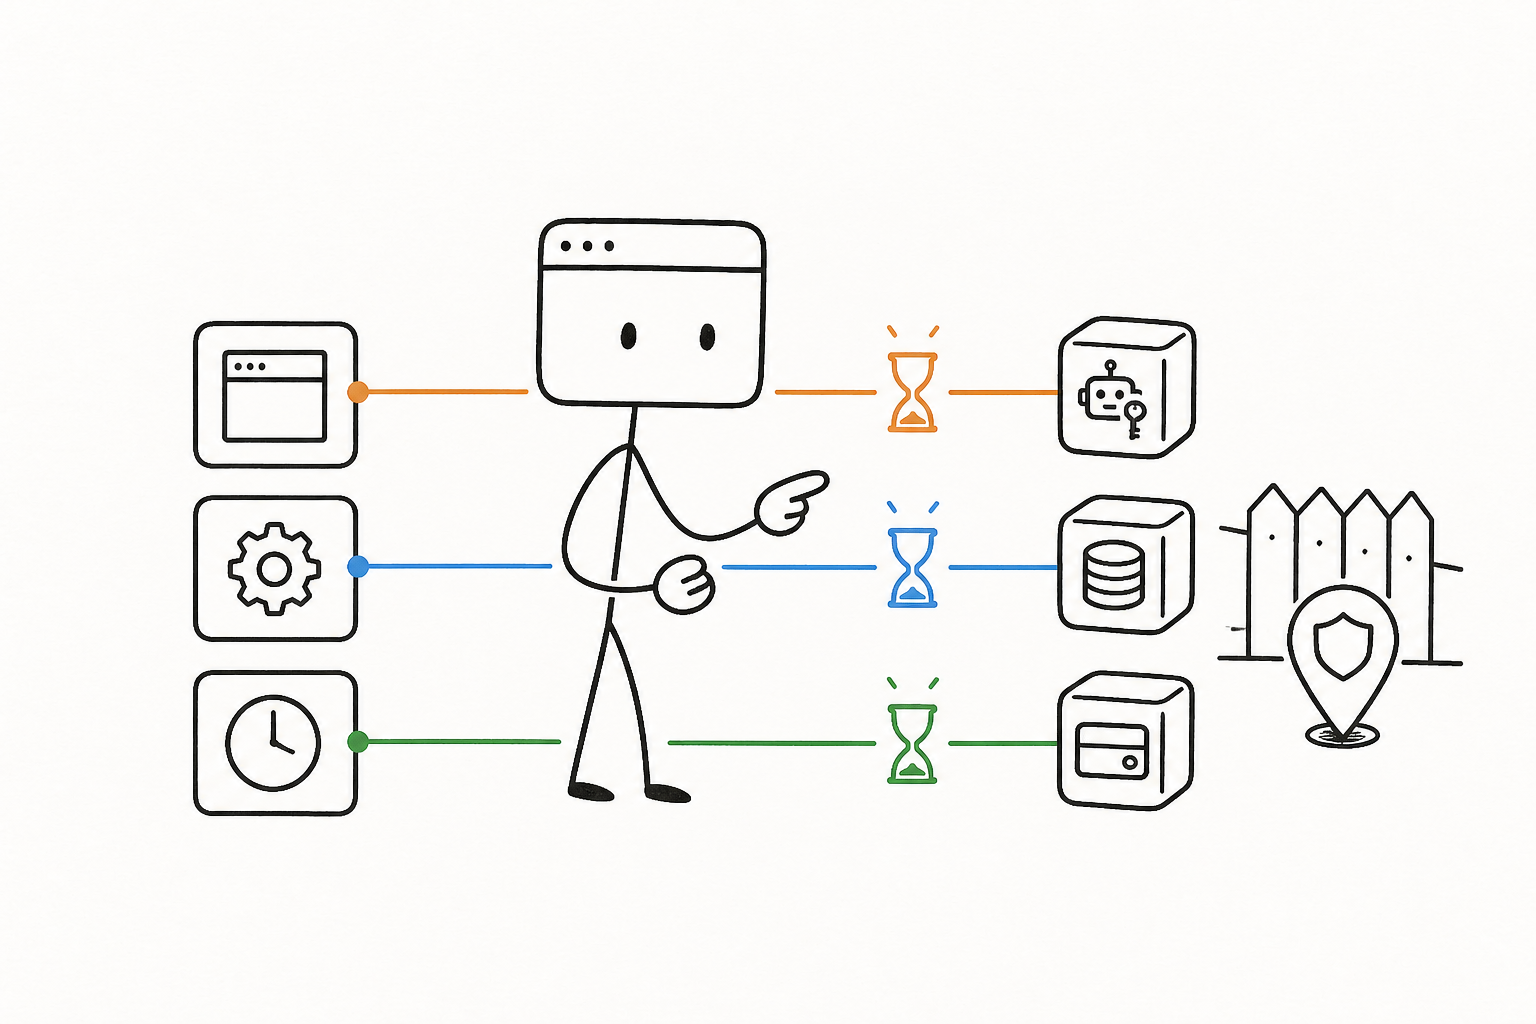
但如果部署平台不支援 OIDC 或雲端 Secret 呢?
這是很多小團隊真正卡住的地方。
你可能用的是 PaaS、低維運部署平台、shared cluster,平台只提供 Environment Variables,沒有 Workload Identity,沒有 OIDC federation,也不能直接掛雲端 IAM role。那怎麼辦?
答案不是「那就沒救」。答案是分層降風險。
| 平台能力 | 建議做法 | 降低了什麼風險 |
|---|---|---|
| 支援 Workload Identity / OIDC / IAM Role | 不要放長期 cloud key。讓服務用平台身分向雲端換短期憑證,再依 IAM policy 讀特定 secret。 | 平台 ENV 被讀到時,攻擊者拿不到可長期使用的雲端 credential。 |
| 不支援 OIDC,但有固定 outbound IP | 把資料庫、第三方 API、內部 token broker 鎖來源 IP;ENV 只放該服務需要的一小把 credential。 | credential 外洩後,攻擊者不一定能從自己的機器直接使用。 |
| 只有 ENV,沒有固定 IP | 每個服務、每個環境拆不同 key;權限縮到最低;設定額度、告警、自動輪替;不要共用 production master key。 | 外洩時爆炸半徑變小,費用與資料存取範圍比較容易控制。 |
| 第三方服務支援 scoped key | OpenAI、Stripe、GitHub、Cloudflare、資料庫帳號都拆用途和權限;不要用 owner/admin 級 key 跑應用程式。 | 被偷的是「只能做一件事」的 key,不是整個帳號。 |
如果平台不支援 OIDC,你可以退而求其次:看能不能固定 IP。固定 IP 不是萬靈丹,但對資料庫、防火牆、內部 API、部分 SaaS allowlist 很有用。
如果連固定 IP 都沒有,那就老實承認風險存在,然後把每把 key 的傷害範圍縮到最小。
最小權限不是一句口號
最小權限要落地,至少要做到這幾件事。
第一,每個服務一組 key。
不要讓前台 web、背景 worker、admin job、cron job 共用同一組 DATABASE_URL、同一把 GitHub token、同一個 Stripe secret。它們需要的權限不一樣,出事時的處理方式也不一樣。
第二,每個環境一組 key。
Development、staging、production 不要共用 secret。測試環境不該拿得到 production 資料庫,也不該能刷 production Stripe。很多事故不是從 production 開始,是從一個比較鬆的 staging 或 preview environment 開始。
第三,第三方 API key 要選最窄權限。
GitHub token 不要給整個帳號所有 repo;Cloudflare token 不要給全域 admin;Stripe key 能限制用途就限制用途;資料庫帳號不要給 owner 權限;AI API key 至少要有 usage limit、budget alert、異常用量通知。
第四,能鎖 IP 就鎖 IP。
資料庫如果必須暴露在公網,至少限制來源 IP。後台管理介面、internal API、SSH、Redis、MongoDB 這些東西尤其不能只靠一組密碼撐著。
第五,輪替要自動化。
「定期輪替」如果靠人記得,就是不會發生。比較務實的做法是寫成 runbook 或 job:建立新 key、部署新 key、確認服務健康、撤銷舊 key、留下紀錄。就算不能全自動,也要做到半自動,讓事故當天不是大家手動到處點。
ENV 裡可以留下什麼?
現實上,多數平台還是需要 ENV。重點不是把 ENV 清空,而是只放「低敏感」或「低爆炸半徑」的東西。
可以放:
- feature flag
- region
- public URL
- non-secret config
- 單一服務需要的低權限 credential
- 短期 credential 的交換設定
盡量不要放:
- 可以讀全部 secrets 的 master key
- owner/admin 級雲端 access key
- production 資料庫 owner 帳密
- 沒有額度限制的 AI API key
- 組織層級 GitHub PAT
- 多個服務共用的 JWT signing secret
特別是 JWT_SECRET 這種東西,很多人低估它。資料庫密碼外洩是資料被讀,JWT signing secret 外洩是身分可以被偽造。攻擊者不一定需要登入你的資料庫,能簽出 admin token 就夠了。
事件發生後,第一小時該做什麼?
如果你收到平台通知,或懷疑自己的 ENV 曾經被讀到,順序不要亂。
- 先撤銷外部可直接濫用的 API key:OpenAI、Anthropic、OpenRouter、Stripe、GitHub、Cloudflare、AWS、GCP、Azure。
- 旋轉資料庫密碼,並檢查資料庫是否允許公網連線。如果可以,立刻加 IP allowlist。
- 換掉
JWT_SECRET、session secret、webhook secret、private key。這類 secret 外洩後,舊 token 可能都要失效。 - 查第三方服務用量、帳單、audit log,尤其是 AI API、雲端資源建立、GitHub Actions、package 發布紀錄。
- 把所有 production secrets 依服務拆開,不要只是原樣換一批新的 key。
- 記錄這次輪替的時間、影響範圍、誰處理了什麼,之後要寫成 runbook。
很多團隊會犯的錯,是只做第一步:把 key 換掉。這當然要做,但如果新 key 仍然是同一把全權限 key、仍然放在同一個 ENV、仍然沒有 IP 限制、仍然沒有告警,那只是把事故往後延。
新系統怎麼設計
如果是今天才要設計新系統,我會用這個順序想:
- 能不能讓 runtime 用 Workload Identity / Managed Identity / IAM Role,不放長期雲端 credential?
- 如果不能,部署平台有沒有固定 outbound IP,可以讓資料庫和內部 API 做 allowlist?
- 每個服務是否有獨立 service account、獨立資料庫帳號、獨立第三方 API key?
- 每把 key 是否都能縮權限、設額度、設告警?
- 輪替流程是否能在 30 分鐘內跑完,不靠某一個人記得所有步驟?
- 平台被攻破時,攻擊者能不能從一個專案橫向移動到整個組織?
這份清單比「用不用 Secret Manager」更重要。Secret Manager 是工具,威脅模型才是設計。
一個真實案例:多租戶後台的前端怎麼分層
講完原則,拿一個手上的系統對照一下。這是一套多租戶的後台管理系統,Vue 3 + Vite 的純前端 SPA,後面接 REST API。對照的目的不是證明它做得多好,而是看「前端」在這個威脅模型裡到底該負責什麼。
第一件事:前端的 ENV 天生公開,所以只能放設定。
Vite 的 VITE_* 變數在 build 時就被打進 bundle,任何人開 DevTools 都看得到。這套系統的 .env 只有這幾類:
VITE_GLOB_APP_TITLE      # 應用標題
VITE_GLOB_API_URL        # API 基底
VITE_GLOB_API_URL_PREFIX
VITE_GLOB_UPLOAD_URL     # 上傳路徑
VITE_PUBLIC_PATH
VITE_KEEP_CONSOLE        # build 是否保留 console
VITE_USE_MOCK
全部是設定,沒有任何 credential。這不是因為團隊特別自律,而是工具鏈逼的:放進去也會外洩,所以根本沒人會放。回頭看前面那個「ENV 抽屜」的問題,前端專案反而是最不容易踩的一層,因為它連「把 secret 藏在 ENV」的幻覺都沒有。
第二件事:連 feature flag 都不走 ENV。
前面我說 ENV 可以放 feature flag。這套系統更嚴:哪個租戶看得到哪個功能,由後端回傳的權限清單決定,前端只照清單渲染選單和按鈕。沒有 VITE_ENABLE_XXX 這種東西。好處是 flag 是 per-tenant 的 runtime 狀態,不是 build-time 常數;壞處是一個坑——曾經有人在路由模組頂層寫 const canSee = getAuthCache(USER_INFO_KEY)?.xxx,模組在登入前就載入,求值一次永遠 false,隔天被撤掉改回 runtime 過濾。憑證和權限都是 runtime 狀態,別在載入期讀,跟 VITE_* 是同一個道理。
第三件事:前端只持有短期 session token,密鑰管理是後端功能。
前端唯一拿在手上的憑證,是登入後從 response header 取的 session token。它不是 API key,不是資料庫連線字串,過期就要重登。真正的 secret 管理全部是後端功能,前端只是操作面板:
- 每個租戶一組對接密鑰,後台有「更換」「更新介面密鑰」「失效」三個獨立操作,上層租戶可以管下層的
- 管理員帳號可綁 TOTP 兩步驗證,流程是產生 secret → 產生 QR → 校驗
- 有 IP 黑名單與 IP 白名單;對外回調另有一道白名單驗證
- 操作日誌記錄 IP、操作者、角色、操作類型(登入、改密碼、改安全設定……)
對照前面的最小權限清單:每個租戶一組 key、可撤銷、IP 限制、稽核、兩步驗證,都有。這套系統上線多年,這些功能不是為了資安演練加的,是被業務逼出來的——牽涉金流的後台,這些是標配。
沒做到的三件事,也老實列出來:
- 輪替靠人。三個密鑰操作都是後台按鈕,沒有排程、沒有到期提醒。前面第五條「靠人記得就是不會發生」直接命中。要補的是 runbook 或 job,不是前端的事。
- session token 落在 localStorage。這是多數 admin 模板的預設,XSS 一旦成立就能讀走。改 httpOnly cookie 是後端改法,前端動不了。
- 測試環境的 proxy 目標 host 寫在
.env.development進了 git。不是 credential,但是內部主機名,屬於情報外洩。該搬去.env.development.local加 gitignore。
第二點我之前在頻道上用白板講過一次:localStorage、cookie、記憶體三種放法各自擋得住什麼、擋不住什麼。跟這篇的結論是同一件事——token 放哪裡,決定的是被攻破時能拿走多少。
這個案例想說的只有一件事:前端專案在這個威脅模型裡的正確姿勢,就是「什麼 secret 都不持有」。它拿短期 token 換後端授權,後端用身分和 IP 決定它能做什麼。Zeabur 事件外洩的那串 DATABASE_URL、JWT_SECRET、STRIPE_SECRET_KEY,在這種分層下前端根本碰不到——爆炸半徑從一開始就被切在後端那一層。
那前端的 .env 到底該放什麼?
寫完案例,還是會有人問:所以前端 .env 是不是乾脆別放東西?不是。它有它的用途,只是要先弄懂一件事:
前端 .env 只放「就算印在網頁原始碼裡也無所謂」的東西。因為它本來就會被印進去。
先搞清楚前綴的意思
| 框架 | 會進 bundle(公開) | 只在 build / server 端 |
|---|---|---|
| Vite | VITE_* |
無前綴,build script 讀得到、bundle 讀不到 |
| Astro | PUBLIC_* |
無前綴,只有 SSR、integration、build script 能讀 |
| Next.js | NEXT_PUBLIC_* |
無前綴,只在 server component、API route |
加前綴,等於你在宣告「這個值可以公開」。但反過來,沒加前綴不等於安全——它還是在 repo 裡、在 CI log 裡、在 build 機器上。前綴只決定「會不會被打進 bundle」,不決定「是不是秘密」。
可以放的四類
- 端點與路徑:API base URL、public path、上傳路徑、CDN base。
- 識別子,不是憑證:GA4 measurement ID、Sentry DSN、Stripe publishable key、Firebase 前端 config、Google Maps browser key。這類 key 的設計本來就是給瀏覽器用的,但要記得在對方後台綁 HTTP referrer 或 domain 限制。
- build 行為開關:要不要保留 console、要不要開 mock、要不要出 sourcemap、壓縮方式。
- 顯示用常數:應用標題、版本號、region。
判準只有一句:這個值被拿走,攻擊者能做的事是「呼叫你本來就對全世界開放的東西」?可以放。能「以你的身分」做事?不能放。
不能放的,就算沒前綴也一樣
- 任何
*_SECRET、*_PRIVATE_KEY、*_TOKEN:GitHub PAT、OpenAI、Stripe secret key。 DATABASE_URL、JWT_SECRET。- 「前端需要直接打第三方 API」的 key。這不是 env 問題,是架構問題。解法是後端代理一層(BFF),或請第三方發短期、限範圍的 token 給前端,而不是把長期 key 塞進 bundle。refresh token 就是這個思路的一種實作:前端拿短命 access token,長命的那把留在後端或 httpOnly cookie。這題我也在頻道講過:為什麼有些網站一個月不開還是登入狀態?refresh token 白話解釋。
- 內網主機名、測試環境帳密。放
.env.local或.env.development.local,gitignore 掉。案例裡那個進了 git 的 proxy host 就是這條。
不該放 env 的「設定」
有兩類東西看起來像設定,但放 env 是錯的:
- per-user、per-tenant 的 feature flag。env 是 build-time 值,改一個 flag 要重 build 就錯了。這種東西是 runtime 狀態,該由後端權限清單或 flag service 決定,前端照清單渲染。案例那套系統就是這樣做的。
- 任何會隨登入者改變的值。同理。
檔案分工
.env                    # 所有環境共用的公開預設,進 git
.env.development        # dev 專用公開值,進 git
.env.production         # prod 專用公開值,進 git
.env.*.local            # 個人機器、內網 host、本機開關,gitignore
.env.production 進 git 沒有問題,前提是裡面真的沒有秘密。反過來說,如果你發現某個值「不太敢 commit」,那它就不該在前端 env 裡。該做的是換個地方放,不是換個檔案藏。
一行自檢
grep -rE 'SECRET|TOKEN|PASSWORD|PRIVATE' .env* | grep -v '\.local'有輸出就該搬家。這行可以直接放進 pre-commit hook。
回到 Zeabur 事件
Zeabur 官方已經說,事件調查還在進行中,完整報告會在內部調查與第三方鑑識完成後發布。現在外面流傳的截圖、推測、責任歸屬,都應該跟官方已確認資訊分開看。
但工程端可以先學到一件事:
部署平台的 ENV 是一個高價值集中點。它一旦被讀到,不只是「設定外洩」,而是整串供應鏈 credential、資料庫 credential、AI API 額度、付款系統、簽章秘密都可能一起暴露。
所以現在要改的不是一句「改用 Secret Manager」而已。
真正應該改的是:
- 不要有 master secret
- 每個服務只拿它需要的 secret
- 能用 identity 就不要用長期 credential
- 能鎖 IP 就鎖 IP
- 能短期就不要永久
- 能自動輪替就不要靠人手
- 事故發生時,先問爆炸半徑,不要只問誰犯錯
資安從來不是保證永遠不被攻破。資安是在每一層被攻破之後,讓下一層還有東西能擋,讓攻擊者拿不到全部。
參考資料
- Zeabur Status:Unauthorized Access to Project Environment Variable Data
- Zeabur Security Practices
- AWS Secrets Manager:Authentication and access control
- Google Cloud IAM:Workload Identity Federation
- Google Cloud Secret Manager:Authenticate to Secret Manager
- Azure Key Vault:Secure your Azure Key Vault secrets