被 AI 拷問過的計畫才敢寫 code:/grill me 在專案開發裡怎麼用
現在的 AI 寫 code 已經不是瓶頸了。給一段描述,五分鐘給你一個能跑的東西。
問題是——它會用同樣的速度,做出一個你其實不要的東西。
我自己踩過最貴的幾次,都不是 code 寫壞,是需求還沒想清楚就開工:做到一半發現資料結構跟後面的需求打架、發現有個邊界情況整個流程要重來、發現當初「先簡單做」的那個決定變成之後每一頁都要繞開的地雷。code 本身沒 bug,但整段時間白花。
/grill me(我用的是 grill-me-codex 這個變體)就是專門處理這件事的:在寫任何一行 code 之前,先讓模型把你問到痛,再讓另一個模型來拆你的計畫。
一句話定義
兩幕劇,各自處理一個失敗模式:
| 階段 | 誰對誰 | 處理的失敗模式 |
|---|---|---|
| Act 1 — Grill | 你 ↔ Claude | 做錯東西(需求/意圖沒對齊) |
| Act 2 — Review | Claude ↔ Codex | 計畫聽起來對、實際會炸(設計有洞) |
你只在兩個時間點出現:回答拷問,跟最後簽核。中間 Codex 全程唯讀,不碰任何檔案。整個過程不寫 code。
怎麼跑起來
裝好 skill 之後(安裝方式看 repo),在 Claude Code 裡直接打:
/grill-me-codex 我想做一個 XXX,大概是這樣⋯⋯想改審查輪數上限就帶參數,預設 5 輪:
/grill-me-codex rounds=3 我想改權限模型⋯⋯Act 2 需要本機有 Codex CLI 並且登入過:
codex --version   # 需要 ≥ 0.130,舊版跑預設模型會直接 error
codex login       # ChatGPT 帳號就可以
不要 pin 模型。用 ChatGPT 帳號認證時指定 gpt-5.x-codex 系列會回 400,讓它吃 config 預設就好。
兩幕的提示詞如果想自己拆開用,原文長這樣。Act 1:
Interview me relentlessly about every aspect of this plan until we reach a
shared understanding. Walk down each branch of the design tree, resolving
dependencies between decisions one-by-one. For each question, provide your
recommended answer.

Ask the questions one at a time, waiting for my answer before continuing.

If a question can be answered by exploring the codebase, explore the codebase
instead.
Act 2 每一輪送給 Codex 的審查提示詞:
You are an adversarial reviewer for an implementation plan. Be skeptical and
specific — your job is to find what breaks, not to be agreeable. Read the plan
at `PLAN.md` and any repo files you need (you are read-only). Identify concrete
flaws: security holes, race conditions, missing edge cases, schema conflicts,
wrong assumptions, observability gaps, simpler alternatives. For each, give a
one-line fix. Do NOT modify any files. End your reply with EXACTLY one line:
`VERDICT: APPROVED` if the plan is sound enough to implement, or
`VERDICT: REVISE` if it still has material problems.跑完會留下兩個檔案:PLAN.md(定稿計畫)和 PLAN-REVIEW-LOG.md(每一輪的批評與回應,append-only)。後者才是真正的產出,後面會講怎麼用。
Act 1:被問到底
Act 1 的核心指令其實只有三句話(這部分沿用 Matt Pocock 的 grill-me,MIT 授權):
針對這個計畫的每個面向拷問我,直到我們達成共識。沿著決策樹的每個分支走,一個一個解決彼此的依賴。
每次只問一題,等我回答再問下一題。
如果這題可以靠讀 codebase 得到答案,就自己去讀,不要問我。
看起來很簡單,但這三句各自擋掉一種爛對話:
「一次只問一題」 擋掉「AI 一口氣丟十個問題,你挑三個好答的回,剩下七個雙方默默當作有共識」。這是我覺得最關鍵的一條——多題並列的時候,人一定會避開最難的那題,而最難的那題通常就是之後會爆的那題。
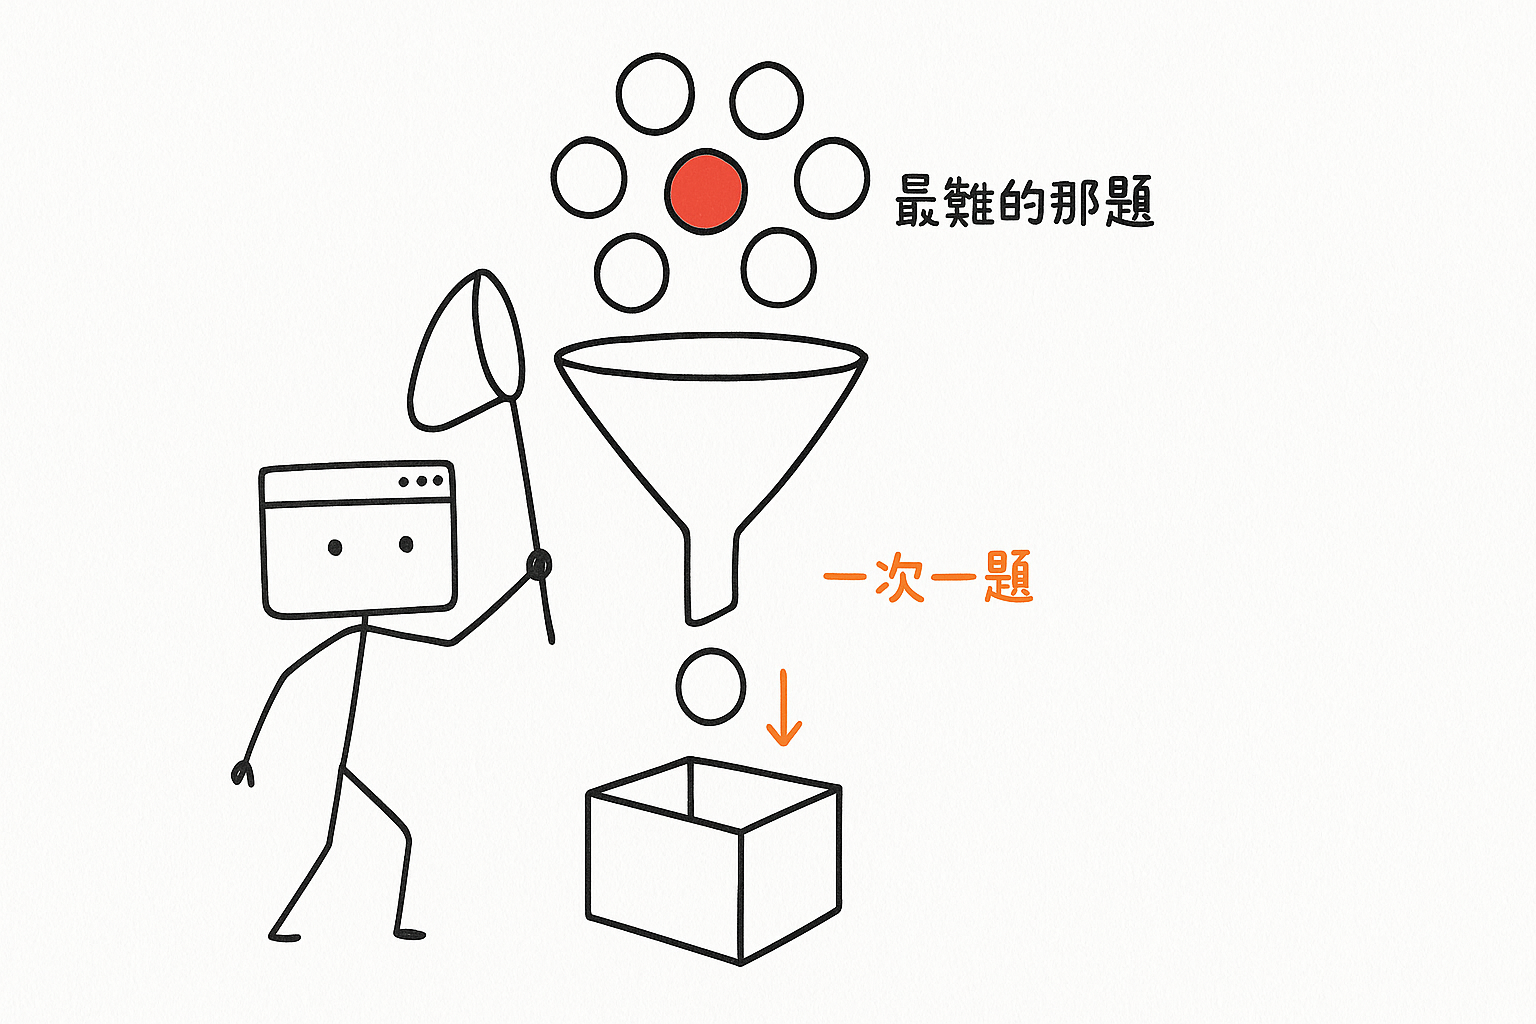
「每題附上建議答案」 擋掉空轉。純提問的 AI 很煩,因為它把思考成本全丟回給你。附建議答案之後,多數題目你只要說「對」或「不對,因為⋯⋯」,而「不對,因為」這三個字後面,往往就是你原本沒意識到自己有的限制條件。
「能查 code 就自己查」 擋掉「AI 問你一個它翻兩個檔案就知道的問題」。你只回答只有你知道的事:商業判斷、優先順序、你願意承擔什麼風險。
拷問結束後,Claude 把結論寫進 PLAN.md,結構固定:目標、做法、關鍵決策與取捨、風險與未決問題、不做什麼。
「不做什麼」那段常常是整份文件最有用的一段。範圍是被拷問逼出來的,不是事後補的。
Act 2:換一個模型來砸
計畫鎖定後,交給 Codex 唯讀審查。給它的 prompt 很直白:你是敵對審查者,要懷疑、要具體,你的工作是找出哪裡會壞,不是當好人。找出安全漏洞、race condition、漏掉的邊界情況、schema 衝突、錯誤假設、觀測性缺口、更簡單的替代方案。每一項給一行修法。最後只回一行 VERDICT: APPROVED 或 VERDICT: REVISE。
REVISE 的話,Claude 改計畫,回到同一個 session 再送一次——所以 Codex 記得它上一輪講過什麼,第二輪不會重複同樣的意見,會直接檢查「你到底改了沒」。跑到 APPROVED 或撞到 MAX_ROUNDS(預設 5)為止。
為什麼要換一個模型,不是叫 Claude 自己審自己?因為同一個模型審自己的計畫就是回音室——它會用產出計畫時的同一組假設去驗證計畫,看起來很認真,實際上只是把原本的盲點重講一次。換一家的模型,訓練資料不同、偏好不同、連「什麼算問題」的直覺都不同。
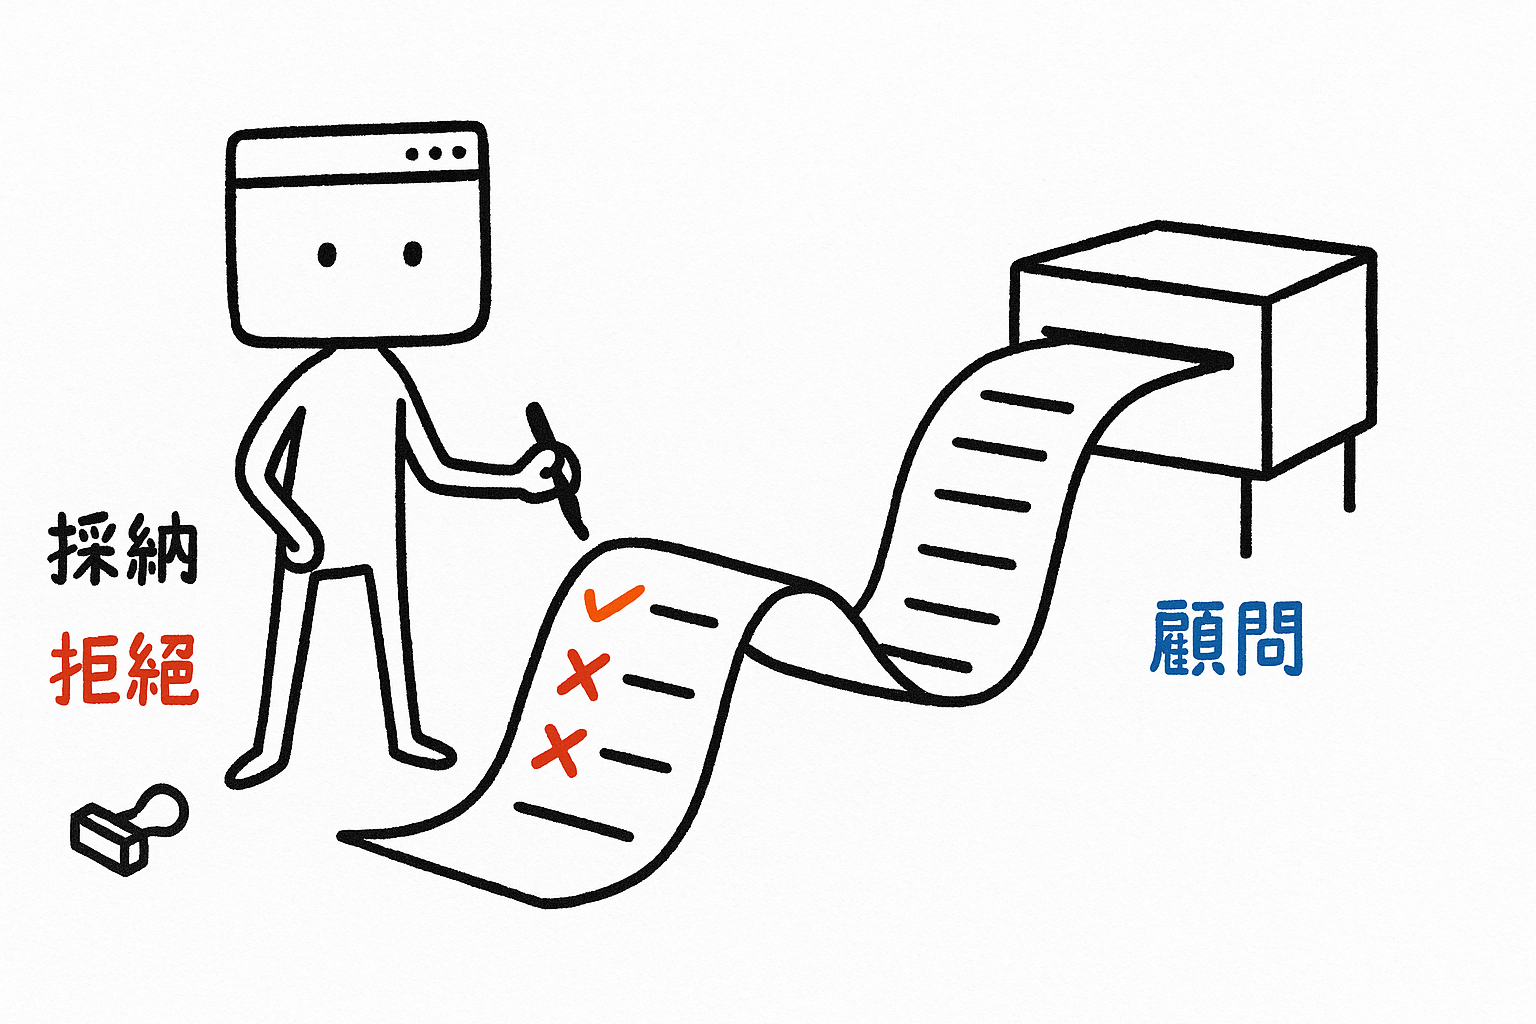
有一條規則我覺得很重要:Claude 是最終仲裁者,Codex 只是顧問。 每個 REVISE 意見,Claude 要判斷哪些真的該改、哪些該拒絕,而且拒絕的理由要寫進 log。全盤接受等於沒有交叉檢查(變成 Codex 說了算),全盤忽略等於沒做這一步。
什麼時候該用、什麼時候別用
這個流程有成本——一輪拷問十幾二十個來回,加上幾輪 Codex,是實實在在的時間。所以場景要挑。
| 情況 | 用不用 | 原因 |
|---|---|---|
| 認證/權限模型 | ✅ 很值得 | 改錯的代價是資安事故,不是重工 |
| 資料庫 schema、migration | ✅ 很值得 | 上線後幾乎不可逆,錯誤會沿著時間複利 |
| 金流、對帳、扣款 | ✅ 很值得 | 錯了就是真的錢,而且邊界情況多到記不完 |
| 並發/狀態同步 | ✅ 很值得 | race condition 是最典型「聽起來很對」的失敗 |
| 跨多頁面的重構 | ✅ 值得 | 影響面大,最貴的是「做到一半才發現要回頭」 |
| 第三方整合(金流、SSO、Webhook) | ✅ 值得 | 對方的限制往往不在你的假設裡 |
| 效能優化方向的取捨 | 🟡 看規模 | 只有幾個檔案就直接做,動到架構才值得 |
| 加一個欄位、改一段文案 | ❌ 別用 | 拷問成本 > 做錯成本 |
| 探索性原型 | ❌ 別用 | 這階段「做錯」正是目的,先做出來再說 |
| 已經寫完的 code 要審 | ❌ 用錯工具 | 那是 code review,不是計畫審查 |
一個簡單的判準:如果做錯了只要改一次就好,直接做。如果做錯了要改十個地方、或改不回來,先拷問。
對專案推進的實際幫助
講幾個我覺得最有感的:
1. 把返工提前到還很便宜的時候
需求階段改一個決定,成本是一句話。實作到一半改,成本是幾百行 code 加上你的心情。上線後改,成本是 migration、相容處理、加上跟使用者道歉。拷問是把「發現想錯了」這件事,硬拉到最便宜的那一格。
2. 決策留痕,而且是免費的
跑完會有兩份文件:PLAN.md(最終計畫)和 PLAN-REVIEW-LOG.md(完整的攻防紀錄——Codex 每輪的批評、Claude 改了什麼、拒絕了什麼、為什麼拒絕)。
第二份是意外之財。三個月後你或同事看到某個奇怪的設計,問「當初為什麼這樣做」,答案不在你腦裡、不在 commit message 裡,它在 log 裡,連當初考慮過又否決的方案都在。這是平常沒人有耐心寫的那種文件,但在這個流程裡它是副產品。
3. 估時會準一點
未決問題是估時最大的雜訊來源。當「這裡要不要支援 X」還沒決定,你估的不是時間,是機率分布。拷問把分支收斂掉之後,剩下的才是真的可以估的工。
4. 團隊裡它能當對齊的媒介
PLAN.md 的「關鍵決策與取捨」跟「不做什麼」兩段,拿去跟 PM 或同事對,比口頭描述有效太多。爭議會集中在具體的取捨上,而不是「我以為你說的是⋯⋯」。
5. 你會發現自己其實沒想清楚
老實說這才是最常發生的。被問到第五、六題的時候,經常出現「⋯⋯欸,這個我沒想過」。那個瞬間的價值,比後面所有自動化都高。
幾個坑
別跳過 Act 1。 直接丟一份自己寫的計畫給 Codex 審(那是 /codex-review 的用法),少掉的正是「你以為的需求 ≠ 真的需求」這一半。Act 1 是一半的價值。
MAX_ROUNDS 用完還沒 APPROVED,不要假裝收斂。 正確做法是把每個未解決的爭點列出來、附上 Claude 的反對立場,交給你裁決。一個被標記出來的分歧,遠比一個假的「通過」有價值。
唯讀那條線要顧好。 codex exec resume 不吃 -s 參數,如果不明確加 -c sandbox_mode="read-only",它會繼承 config.toml 的設定——而那可能是 full access。審查者變成能改檔案的話,整個「唯讀第二意見」的前提就沒了。
非互動環境要餵 < /dev/null。 codex exec 除了 prompt 參數之外還會讀 stdin,在 Claude Code 的 Bash 工具、CI、任何非 TTY 的管線裡,它會安靜地等 stdin EOF 等到天荒地老——CPU 幾乎 0%,看起來像在思考,其實是掛了。這種 hang 最難查,因為它不報錯。
別 pin -codex 系列的模型。 用 ChatGPT 帳號認證時會直接 400。讓它吃 config 預設就好。
有寫文件的專案,用另一個變體
如果專案已經有 CONTEXT.md、詞彙表或 ADR,grill-with-docs-codex 更合適:Act 1 會拿你的計畫去對現有的領域模型和詞彙,戳破模糊的名詞,並且在決策成形的當下就把 CONTEXT.md 和 ADR 一起更新。
差別在於,它不只問你「你要什麼」,還會問「你講的這個詞,跟你們文件裡那個詞是同一件事嗎」。用過就知道,那經常不是同一件事。
小結
AI 讓實作變便宜之後,成本重心整個移到「決定要做什麼」上。以前是想清楚很快、做很慢;現在反過來。工作流也該跟著反過來:把時間花在拷問和審查,實作反而是最後那段最輕鬆的路。
一個粗略的心法:做錯要付出的代價,超過一次拷問的時間,就先被拷問。